【2026年9月最新】AI勢力図|LLM・ローカルAI・画像・動画・音声を用途別比較
今のAIの現在地を一枚に整理
AI市場は頻繁に新しいモデルがリリースされます。また、用途に応じて本当に数百数千種類以上ものモデルが存在し、その派生物を含めるとさらに多く、企業から個人まで日々研究しています。
なので、このサイトでは、「今、何が強いのか」「用途ごとに何を選べばいいのか」を、継続収集しているベンチマーク・価格・モデル仕様からできる限り中立に、整理、説明していきます。
最終更新 2026.09.17
目次16項目開く
色々なAIの簡単紹介
まず、最近AIを学び始めた人にもわかるように現在のAIについて軽く説明していきます。わかる人は飛ばしてください。→「最新AI勢力図を見る」
現在のAIを理解するうえでは、5つに分けると整理しやすいです。
- LLM
- 画像生成モデル
- 動画生成モデル
- 音声モデル
- ロボティクスAI
LLMは、Large Language Modelの略で、文章を理解し、会話・要約・検索・推論・コーディングなどを行うAIモデルです。現在の生成AIの中心的な存在です。
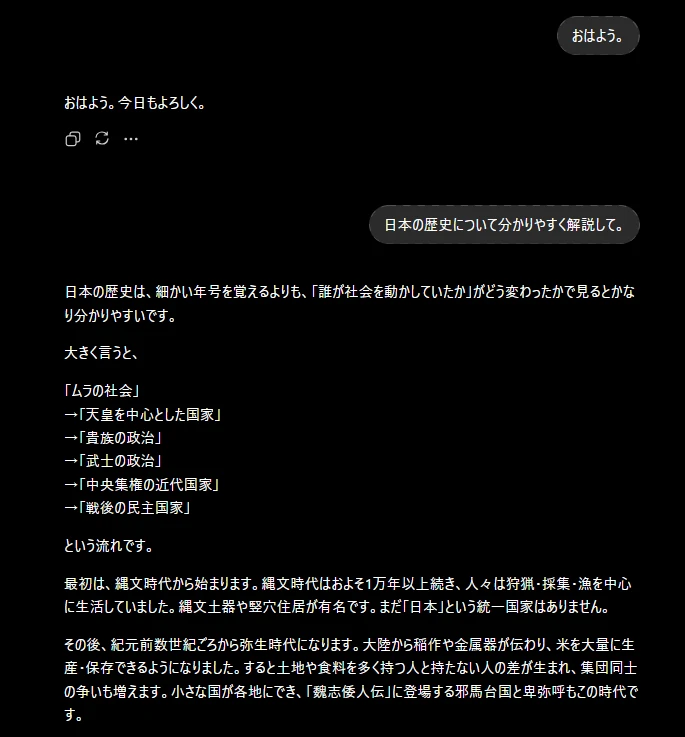
これは、普段多くの人が利用している使い方ですね。プログラミングやより専門的なタスクを行う人は、Claude CodeやCodexと呼ばれるAIエージェントを利用しています。これはLLMが回答するだけでなく、パソコンにあるファイルを直接読み、コードを書き、ツールを使いながら、複数の工程を自律的に進める仕組みです。条件次第では、1日ずっと作業を行わせる事も出来ます。
画像生成モデルは、文章や画像をもとに、新しい画像を生成・編集するAIモデルです。
代表的なものが、生成したい内容を文章で入力して画像を作る「T2I(Text-to-Image)」です。また、既存の画像を入力して編集したり、人物・構図・画風などを参考に新しい画像を生成したりすることもできます。
AIに「何を生成してほしいか」を伝えるために入力する文章を「プロンプト」と呼びます。イラスト、写真、広告、デザイン制作など、幅広い用途で使われています。
他の画像生成方法を詳しく見る
- Image Editing:画像を渡して、言葉で直す。例:「服を黒にして」「背景を東京にして」「人物を消して」
- Reference-to-Image:画像を「お手本」として使い、新しい画像を生成する方法。例:「この人物の特徴を保ったまま、海辺にいる画像を作る」元画像そのものを編集するのではなく、人物・商品・服装・画風などを参考に別の画像を生成する。
- Controlled Generation:ポーズや構図、奥行きなどの情報を指定して、生成結果を細かくコントロールする方法。 例:Pose-to-Image:このポーズで作る・Depth-to-Image:この奥行きで作る・Edge-to-Image:この輪郭に合わせる・Sketch-to-Image:このラフ絵を完成させる・Layout-to-Image:人物や物の配置を指定する。
- Multi-reference Generation複数のお手本を組み合わせる。例:「人物は画像A、服は画像B、背景は画像C」→ Reference-to-Imageの発展形。
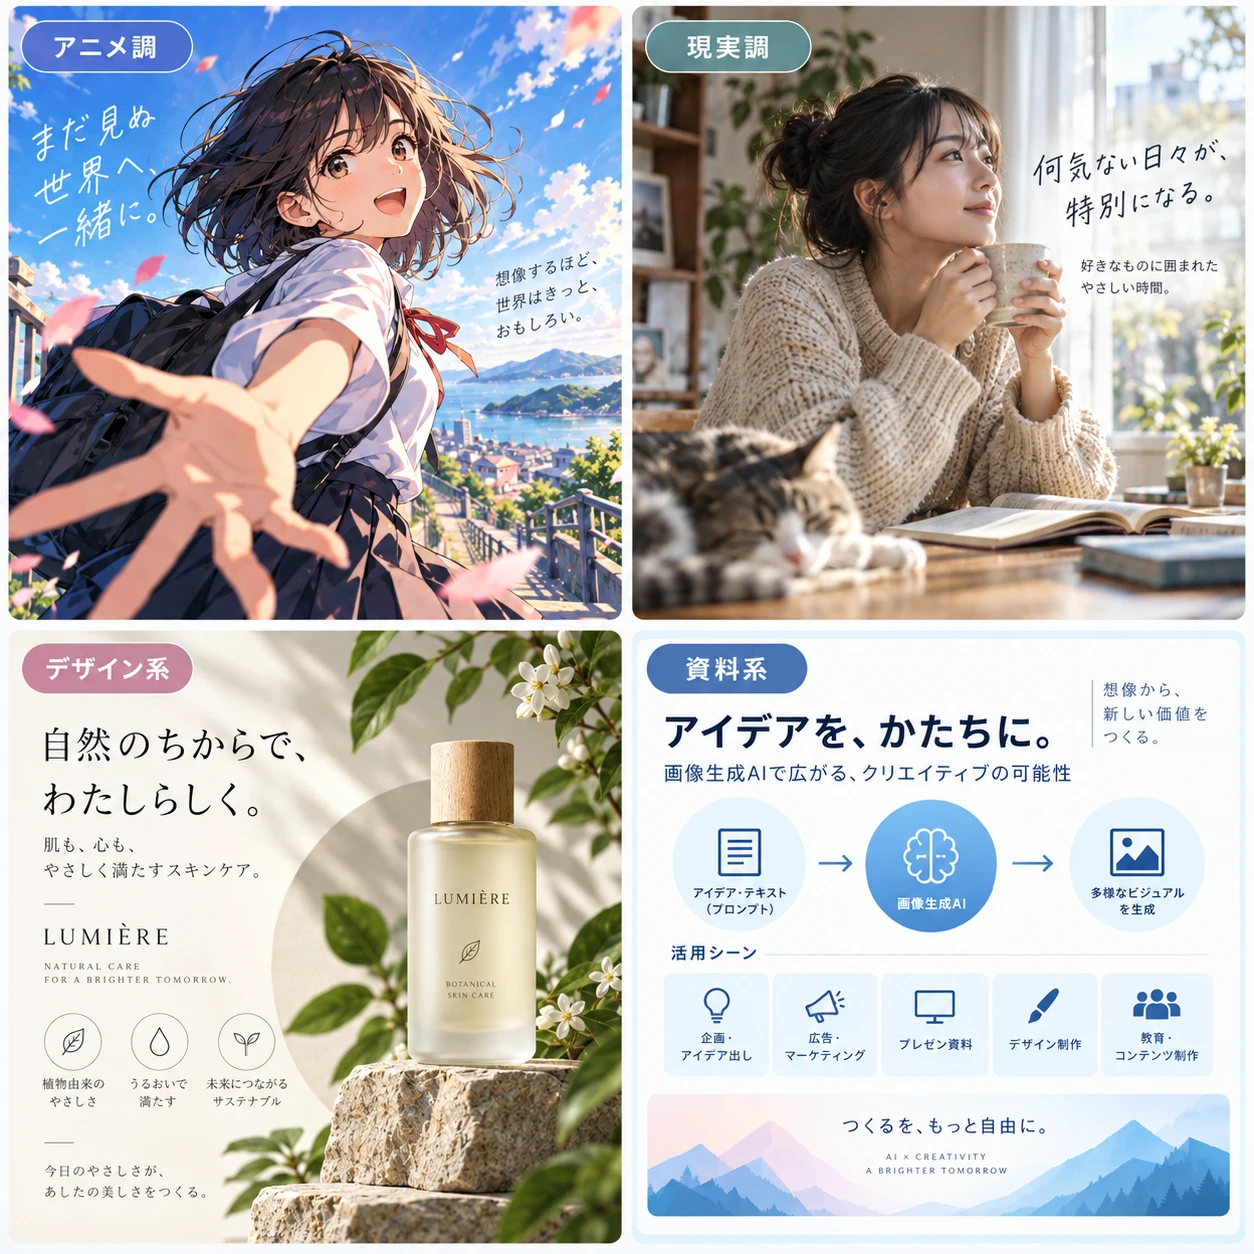
かなり適当なプロンプトですが、こういった画像が一瞬で出来るのはなかなかすごい事なのではないでしょうか。ただ、実際やってみると、かなり奥が深いです。思い通りの構図にするための言語化能力が重要です。
なにかとよく世間の話題に上がるのもこの画像生成AIが多いですね。
動画生成AIは、文章や画像をもとに、新しい動画を生成・編集するAIモデルです。文章から動画を生成する方法「T2V(Text-to-Video)」や、1枚の画像を動かして動画にする方法「I2V(Image-to-Video)」、既存動画の動きや構図を活かしつつ、画風・人物・背景などを変える方法「V2V(Video-to-Video)」などがあります。
他の動画生成方法を詳しく見る
- Reference-to-Video:画像や動画を「お手本」として参照し、新しい動画を生成する方法。例:「この人物の特徴を保ったまま、街を歩く動画を作る」元画像をそのまま動かすI2Vとは異なり、人物・商品・服装・画風などを参考に別の場面を生成する。
- Video Editing:既存動画を、文章で指示して編集する方法です。例:「背景を雪山に変える」「人物の服を黒くする」「昼を夜に変える」
- Controlled Generation:動きやカメラなどを指定して、生成する動画を細かくコントロールする方法です。例:Motion Control「人物や物体の動きを指定する」、Camera Control「ズームやパン(カメラを左右に振る動き)などを指定する」、Start / End Frame「開始と終了の画像を指定する」
- Multi-reference Generation:複数の画像や動画を「お手本」として参照し、新しい動画を生成する方法です。例:「人物は画像A、服は画像B、背景は画像Cを参考にする」Reference-to-Videoを複数の参照素材に広げたものです。
これはT2Vです。動画生成AIは、基本的に数秒から長くて15秒くらいの動画しか作れません。そのため、AIでドラマや映画のような長い映像を作る場合は、場面を短いショットに分けて生成して後で繋げていく形が主流です。
調べてみると、意外とAI映像作品がYoutubeにあがっています。以下の2つは、個人的に見て面白かったものです。どちらも心を動かされる作品です。
まだAIっぽさや細部の粗はありますが、普通に映像作品として楽しめるレベルに達していると思います。ここからさらに進化していくと思うと楽しみです。
また、Amazonは、動画生成AIクリエイターを支援するための組織「GenAI Creators’ Fund」を立ち上げています。個人だけでなく、大規模な組織でもAI映像制作の導入は進んでいます。
音声生成AIは、文章や音声をもとに、人の声や音楽、効果音などを生成・編集するAIモデルです。文章から自然な話し声を生成する「TTS(Text-to-Speech)」、音声の特徴を再現する「Voice Cloning」、文章から効果音や環境音を生成する「Text-to-Audio」などがあります。
これによって、会議の文字起こしや動画のナレーション、吹き替え、リアルタイム翻訳、楽曲制作など、これまで録音や演奏、編集が必要だった作業をAIで行えるようになっています。
他の音声AIを詳しく見る
- STT(Speech-to-Text):音声を文章に変換する方法。会議の文字起こし、字幕作成、音声入力などに使われる。
- Speech-to-Speech:音声を直接別の音声へ変換する方法。話し方やイントネーションを保ちながら、声質や言語を変えることができる。
- Speech Translation:話している音声を別の言語へ翻訳する技術です。音声から音声へ直接翻訳するモデルもあり、リアルタイム翻訳や吹き替えに使われます。
- Audio Understanding:会話や音楽、環境音など、音声に含まれる情報をAIが認識・理解する技術です。「誰が何を話しているか」「どんな音が鳴っているか」といった内容を分析できます。
- Music Generation:文章などから楽曲やBGMを生成する方法。ジャンル、雰囲気、楽器、歌詞などを指定して楽曲を作れるモデルもある。
- Audio Editing / Enhancement:既存の音声を編集・改善する技術です。ノイズ除去、声とBGMの分離、音質改善、不要な音の除去などに使われます。
また、音声対話できるモデルもあります。チャットの代わりとして、友人のように会話や相談をしたりする事が可能です。実際に日本語で利用してみても、かなり自然な形で会話できます。
ロボティクスAIは、ヒューマノイド、ロボットアーム、四足歩行ロボット、ドローンなどが含まれます。近年は、こうした現実世界で動くAIを「フィジカルAI」と呼ぶことも増えています。
自動運転AIも広義にはロボティクスの一種ですが、一般には独立した分野として扱われることが多いです。
ロボティクスAIは、カメラやセンサーから周囲の状況を認識し、何をするべきか判断して、ロボットの身体を動かします。人間の指示を理解して行動する「VLA(Vision-Language-Action)」や、シミュレーション上で動作を学習して実世界に応用する技術など、さまざまなアプローチが研究されています。
一応、どちらも企業の公式動画です。
LLMと比べるとまだ発展途上の分野で、AIモデルの構成や学習方法、センサーの使い方、ロボットの制御方法などは各社で大きく異なっています。
私たち消費者が使えるのは主に最初に挙げた4つ、将来的にロボティクスが使える可能性が高いのでこの5つの分類で理解するといいと思います。
また、LLMが画像を読み込むことが出来たり、ロボットを動かせたりと分野を横断できるモデルも存在します。そういったAIモデルはマルチモーダルモデルと呼ばれています。しかし、最近はLLMが割と何でも出来るようになってきたので、少しこの概念が薄れつつあります。
そろそろ本題の勢力図に入ります。ただ、これを作るにあたって比較方法をかなり悩みました。AIモデルの評価方法の1つとして何十種類のタスクを行った成功率を測るベンチマークがあります。しかし、調べてみると分かるのですが、全てのAIモデルが同じベンチマークをやっているわけではないため、そもそも比較の土台に挙げらない問題があります。さらに、benchmaxxingというスラングもあるように、ベンチマークに最適化されスコアが高いだけで、実用性があまりよくないモデルも多く出てきています。
なので、このサイトでは、LMArenaというサイトを主に利用していきます。
LMArenaは、ユーザーのプロンプトに対し、2つのモデルを同時に出力して、その出力をユーザーが評価する事でランキングを作っているサイトです。ユーザーが実際に使用感を測るので、比較的コミュニティ評価に沿ったランキングとなっています。
本サイトでは、基本的にこのLMArenaと企業がモデル発表時に同時に公開するベンチマーク、価格料金を使い、合成スコアを出し、それを「ちまとめスコア」として、ランキングにしています。
ただ、最初に言及した通り、全てのデータがあるわけではなく、推測値を用いて一部補完しているので、正確性を保証するものではないのはご了承ください。
基本的に、近年でたモデルを全てをまとめて数値化しています。また、モデルの重みが公開されており計算資源さえあればだれでも利用できるオープンウェイトモデルは、別軸でオープンウェイトだけで比較しています。なので、「企業が提供するクラウドAI+オープンウェイトAI」のランキングと、「オープンウェイトのみ」の2つのランキングがある形です。
また、LLMの「クラウドAI+オープンウェイトAI」のランキングに関しては、モデルの数も多いため、利用料金の価格帯で3つの階級に分けています。
2026年9月 — まず見るAI勢力図
| 用途 | 現在の有力候補 | 特徴 |
|---|---|---|
| 高価格帯クラウドLLM | Claude Fable 5.1 /GPT6 Astra | どちらも未解決問題を解く最強モデル |
| 中価格帯クラウドLLM | Qwen3.8 Max | フロントエンドが強い |
| 低価格帯クラウドLLM | GLM-5.3 Flash / GPT-5.6 Luna / Hy3 | GLMが強いが、Lunaのサブスクコスパ〇 |
| ローカル LLM | GLM-5.3 Flash / Qwen3.8-27B | Qwen3.8 27Bは、(パフォーマンス/パラメータ)最強 |
| クラウド画像AI | GPT Image 2.5 | T2Iと画像編集で明確なトップモデル |
| ローカル画像AI | Ideogram 4.0 / HiDream O1 Image / FLUX.2 Klein 4B | モデルによって得意な画風とかがあるので、一概に評価しずらい |
| クラウド動画Ai | Seedance 2.5 / Gemini Omni Flash / MiniMax H3 | 3モデルはT2V・I2V・編集全てで競う形。 |
| ローカル動画AI | MiniMax H3 | ローカル動画AIで唯一、品質側が大きく先行 |
1. クラウド +オープンウェイト LLM — 価格帯ごとに見る
クラウドLLMは、現在のAPI価格からHIGH / MID / LOWの3階級に分けています。この3階級間は、同じ計算式なので比較可能です。
ここで使うAPI料金とは、ChatGPTなどの月額料金ではなく、開発者がAIモデルをプログラムから利用するときに、処理した文章の量に応じて支払う料金です。
3階級に分ける具体計算式とトークンの解説。
LLMのAPI料金は、基本的に「入力した文字」と「AIが出力した文字」の量に応じて決まります。この量を数える単位がトークンです。
トークンは文字数そのものではなく、AIが文章を処理するときの細かい単位です。日本語では1文字=1トークンとは限らず、文章の内容やモデルによって多少変わります。
たとえばAPI価格に、
- 入力:$0.75 / 100万トークン
- 出力:$3.75 / 100万トークン
と書かれている場合、100万トークン入力すると0.75ドル、100万トークン出力すると3.75ドルかかるという意味です。
「ちまとめスコア」では、モデルを価格帯で比較するために次の価格指数を使っています。
価格指数
= 入力料金
+ 出力料金 × 0.2
出力料金を0.2倍しているのは、一般的な利用では「入力した量」と「出力される量」が1:1にはならず、入力の方が多くなりやすいためです。
先ほどの例なら、
0.75 + 3.75 × 0.2
= 1.50
となります。
この価格指数を使って、3つの価格帯に分けています。
LOW   :1以下
MID   :1超〜5以下
HIGH  :5超
たとえば価格指数1.50のモデルはMIDに分類されます。
なお、これは「実際に1回使ったときの料金」を直接表す数字ではなく、モデル同士を同じ基準で価格比較するための指数です。通常の公開API価格を基準にしています。たまに割引とか深夜サービスしている企業もあります。
実際に私たちが利用するのは、特定の企業にサブスクして使う事が多いと思います。通常のAPI料金よりも安く多く使えるサブスクを加味するとおすすめなモデルの評価はまた変わってきまが、それらは考慮できないため、このランキングは、API料金ベースの単純なモデルスペックとしての評価である事に注意してください。
「クラウド +オープンウェイト LLM」の計算式を詳しく見る。
LMArena(60%)
用途別に評価項目が分かれています。そのため、モデルの情報量やバランスなどを考慮して比率を決めてます。
- Text(20%)一般的な文章での総合力です。質問への回答、説明、要約、推論など、普段LLMを使うときの幅広いテキスト能力を評価します。
- Agent(20%)AIがエージェントとして作業を進める能力です。一問一答ではなく、複数の手順を考えながらツールなどを使い、より長期的な目的を達成できるかを評価します。
- WebDev(10%)WebサイトやWebアプリを作る能力です。指示に沿ってUIやレイアウト、機能を実装し、実際に使える形へ仕上げる能力を評価します。
- Vision(5%)画像や図、スクリーンショットなどを理解する能力です。画像内の情報を読み取り、それをもとに回答・推論できるかを評価します。
- Japanese Text(5%)日本語での回答品質です。単なる翻訳能力ではなく、日本語で質問したときの自然さや内容の良さを評価します。LLMが出力する文章は、読みずらく理解に時間がかかる事が多いので、作業効率的にも意外と重要な要素です。
企業公式ベンチマーク(30%)
各社がモデル発表時などに公開している主要ベンチマークの結果を使い、LMArenaだけでは捉えにくい推論・数学・コーディングなどの能力を補います。ただ、他社に勝ってる見栄えの良いベンチしか出さない企業もいるので注意です。
Agent Task Efficiency(10%) LMArenaのAgent評価で、1つのタスクを完了するまでにかかった実質コスト。同じタスクを完了するまでに必要なトークンがモデル毎に異なるので、このタスク効率が重要です。同じ価格帯のモデル同士で、より低コストにタスクを処理できるモデルを高く評価します。
HIGH — 能力を優先する高価格帯
Fable 5.1、Astraの2強です。続いてClaude Opus 5、Claude Fable 5です。Kimi K3もオープンウェイトではありますが、かなり高い位置にいます。
Frontier LLM Chimatome Score — HIGH league
| 順位 | Model | 開発元 | ちまとめスコア |
|---|---|---|---|
| 1 | GPT-6 Astra | OpenAI | 73.19 |
| 2 | Claude Fable 5.1 | Anthropic | 83.06 |
| 3 | Claude Opus 5 | Anthropic | 80.74 |
| 4 | Claude Fable 5 | Anthropic | 79.02 |
| 5 | Kimi K3 | Moonshot AI | 75.47 |
| 6 | Claude Opus 4.7 | Anthropic | 73.07 |
| 7 | GPT-5.6 Sol | OpenAI | 71.42 |
| 8 | Claude Opus 4.8 | Anthropic | 71.18 |
| 9 | GPT-5.5 | OpenAI | 65.15 |
| 10 | GPT-5.4 | OpenAI | 62.22 |
| 11 | Claude Sonnet 4.6 | Anthropic | 58.37 |
GPT-6 Astraは、まだデータが少なく中央値だと68.80になりますが、ベンチマークやコミュニティ評価的には、流石に80後半から90点あるので暫定1位にしています。Claude Fable5.1よりもベンチマーク自体は高いものが多いですが、実際に利用する人の声を見てみると、同等の評価くらいな印象です。
LLMは、会社によってかなり性格に差が現れます。GPT系列は、かなり過集中しがちで、オーバーエンジニアリングをしやすい傾向にあります。また、出力する日本語もかなり読みずらいです。
Claude系列は、GPTよりも人間の意図とかを的確に拾ってくれるので、意思疎通しやすいです。しかし、GPTと比べると実装の細部に粗が目立つ傾向にあります。
なので、Claudeと話しつつ大枠の設計を決め、その設計をGPTに細部まで詰めてもらい穴を埋めてもらうみたいな使い方がおすすめです。
MID — 現在もっとも競争が激しい価格帯
MIDではQwen3.8 Maxが先頭です。HIGHは、3社しかいなかったですが、MIDはかなり多くの企業が混在しています。かなり中国企業が多いですね。
Frontier LLM Chimatome Score — MID league
| 順位 | Model | 開発元 | 知まとめスコア |
|---|---|---|---|
| 1 | Qwen3.8 Max | Alibaba | 66.47 |
| 2 | Kimi K2.6 | Moonshot AI | 62.83 |
| 3 | Dola Seed 2.0 Pro | ByteDance / BytePlus | 62.18 |
| 4 | DeepSeek V4 Pro 0813 | DeepSeek | 61.84 |
| 5 | Gemini 3.8 Flash | 61.32 | |
| 6 | GLM-5.3 | Z.ai | 60.84 |
| 7 | GLM-5.1 | Z.ai | 60.66 |
| 8 | Gemini 3.7 Flash | 57.15 | |
| 9 | Gemini 3.5 Flash | 56.64 | |
| 10 | Claude Sonnet 5 | Anthropic | 54.82 |
| 11 | Grok 4.6 | xAI | 54.35 |
| 12 | Qwen3.6 Max Preview | Alibaba | 53.11 |
| 13 | GLM-5.2 | Z.ai | 51.71 |
| 14 | Qwen3.8-27B | Alibaba | 51.07 |
| 15 | Grok 4.3 | xAI | 50.68 |
| 16 | Qwen3.8 Max 0902 | Alibaba | 50.25 |
| 17 | GPT-5.6 Terra | OpenAI | 50.08 |
| 18 | Qwen3.5-397B-A17B | Alibaba | 49.79 |
| 19 | Grok 4.5 | xAI | 49.32 |
| 20 | Mistral Medium 3.5 128B | Mistral AI | 49.18 |
| 21 | Muse Spark 1.2 | Meta | 49.03 |
| 22 | GPT-5.4 Mini | OpenAI | 48.07 |
| 23 | Kimi K2.7 Code | Moonshot AI | 46.92 |
| 24 | Qwen3.5-122B-A10B | Alibaba | 43.69 |
| 25 | Gemini 3.6 Flash | 43.15 | |
| 26 | Gemini 3.1 Pro Preview | 42.26 | |
| 27 | Inkling | Thinking Machines Lab | 40.14 |
| 28 | Qwen3.7 Max | Alibaba | 40.04 |
Qwen3.8 Maxは、Preview→無印→0902というリリース順です。基本的に日にち付きモデルは後からリリースされたものとなります。0902に関してはGPT6 Astraと同様にデータが少ないため低い順位となっていますが、ベンチマークもLMArenaの順位も無印より向上しているので首位になると思います。
あと、面白いのはGemini系です。最近Google Geminiは酷評されがちですが、日本語の文章性能だけはずば抜けて良いとの評価があります。日本語性能に関しては、Claude Fable5.1、GPT6 Astraを超えるので執筆系や文章整理にはお勧めです。ただ、コーディングなどエージェント的な長期作業をさせると微妙なので注意してください。
LOW — 安さと実用性能の勝負
LOWではGLM-5.3 Flashが先頭です。続いてGPT-5.6 Luna、Hy3が有力です。
Frontier LLM Chimatome Score — LOW league / current projection
| 順位 | Model | 開発元 | 知まとめスコア |
|---|---|---|---|
| 1 | GLM-5.3 Flash | Z.ai | 58.46 |
| 2 | Muse Glimmer | Meta | 57.42 |
| 3 | Qwen3.6-27B | Alibaba | 54.90 |
| 4 | NVIDIA Nemotron 3 Ultra 550B-A55B | NVIDIA | 53.95 |
| 5 | Hy3 | Tencent | 53.06 |
| 6 | Gemma 4 31B | 52.78 | |
| 7 | Amazon Nova 2 Lite | Amazon | 51.95 |
| 8 | GPT-5.6 Luna | OpenAI | 51.60 |
| 9 | DeepSeek V4 Flash 0731 | DeepSeek | 50.81 |
| 10 | Qwen3.6 Plus | Alibaba | 50.47 |
| 11 | Solar Pro 4 | Upstage | 50.41 |
| 12 | Qwen3.6-35B-A3B | Alibaba | 49.56 |
| 13 | GPT-OSS-120B | OpenAI | 48.82 |
| 14 | Gemma 4 26B-A4B | 47.87 | |
| 15 | Qwen3.8 Flash Next | Alibaba | 47.65 |
| 16 | MiMo V2.5 Pro | Xiaomi | 44.99 |
| 17 | NVIDIA Nemotron 3.5 Lightning 30B-A3B | NVIDIA | 44.67 |
| 18 | Qwen3.7 Plus | Alibaba | 44.01 |
| 19 | MiniMax M3 | MiniMax | 42.48 |
| 20 | NVIDIA Nemotron 3 Super 120B-A12B | NVIDIA | 40.56 |
| 21 | GPT-OSS-20B | OpenAI | 39.59 |
| 22 | Gemini 3.5 Flash Lite | 24.65 | |
| 23 | MiniMax M2.7 | MiniMax | 23.90 |
| 24 | Inkling Small | Thinking Machines Lab | 20.10 |
意外と面白い結果になっているんじゃないでしょうか。この価格帯だと、クラウドモデルよりもオープンウェイトモデルの方が明確に多いです。中には、世代が進んだにもかかわらず評価が悪くなっているものもあります。ベンチでは良くみえていたが、実用性は低下していたという形ですね。
少し余談です。
これは陰謀論なのですが、結構コミュニティでは言われている話で、モデルの推論効率や計算資源節約のために企業はリリース後にかなり最適化をしているのですが、この過程で性能が落ちるという事が噂されています。
実際にRedditでは。2026年3〜4月に「Opus 4.6が急に馬鹿になった」という報告が大量に出ていて、AMDのAI Directorによる約7,000セッションの分析まで話題になりました。コードを読む量の減少、途中放棄、全面書き換え増加などを測ったものです。それを受けて、Anthropic自身が2026年4月23日に、実際に裏側でClaude Codeの性能を落としていた変更を認めています。
また、Anthropicは、Moonshotが約2300万件、DeepSeekが約1210万件のユーザー要求をClaudeへルーティングし、そのデータを集めていたと報告しています。そもそもの使っているモデルが違うというとんでもない仕様です。
こういう風に、内部で何か変更があっても必ずしもユーザーに伝わるわけではないので、継続的に性能を測るベンチマークは重要だと思っています。
余談その2(上級者向け)
現在のAIサービスでは、「同じモデル名なら同じ性能」とは限りません。
たとえばKimi K3のようなオープンウェイトモデルは、開発元のAPIだけでなく、FireworksやTogetherなどの第三者がホストして提供することがあります。OpenRouterのようなゲートウェイを使うと、その裏側で複数のホスティング事業者のいずれかにリクエストが送られます。
このとき、量子化の方法、推論設定、コンテキスト処理、KVキャッシュ、サービング環境などが提供元ごとに異なるため、同じモデルでも実際の性能や速度に結構差が出ます。
Kimi K3だけでも現在16のhostがあり、同じK3なのにGPQA Diamondというベンチマークでprovider間でも約90.8〜93.8%と振れ幅がある形です。
実際に利用している人の話でも、特に OpenCode Go や OpenRouter 経由のオープンウェイトモデルについて、「公式APIより明らかに弱い」「instruction following が崩れる」「長文でループする」という報告があります。
OpenCode GoやCommand Codeなどは色々なモデルを使えたり、安いモデルを割引で利用できたりと便利なのですが、こういう事情も考慮してタスクを振り分けるといいと思います。
2. ローカル / オープンウェイト LLM — 小ささも性能の一部
オープンウェイトモデルでは、単純に「一番賢いモデル」が一番評価できるとは限りません。自分のPCや法人のワークステーションで動かす場合、モデルの大きさそのものが必要なメモリや計算資源に直結するためです。
特に最近は、すべてのパラメータを毎回使うDenseモデルだけでなく、必要な部分だけを呼び出して推論するMoE(Mixture of Experts)モデルも増えています。たとえば総パラメータが100Bでも、1回の推論では20B程度しか使わない、といったモデルがあります。
さらに、実際に必要なメモリ容量はパラメータ数だけでは決まりません。モデルの数値を何bitで保持するかによっても大きく変わります。
Denseモデルの Qwen3.8-27B は約270億パラメータです。weightsだけを単純計算すると、
- 16bit:約54GB
- 8bit:約27GB
- 4bit:約13.5GB
- 2bit:約6.8GB
となります。つまり、同じ27Bモデルでも、4bitまで量子化すれば約13.5GBと必要容量は16bit時の約1/4になります。これなら50GB超だったモデルが、RTX 4090やRTX 3090のような24GB VRAM(GPU搭載のメモリ)のGPU 1枚でも動かせるサイズになります。
このようにより少ないbit数でモデルを表現する技術を「量子化」と呼びます。ただし、bit数を下げると必ず同じ能力を維持できるわけではなく、特に2〜3bit級では推論やコーディング性能が大きく低下することがあります。
ただ最近では、Kimi K3やGPT-OSSのように、最初から4bit量子化を前提として学習されたモデルもあります。この場合、4bit版が単なる軽量版ではなく、開発元が想定する標準モデルとなります。
ローカルAIのコミュニティでは、用途によって使われるサイトやツールにも少し違いがあります。
LLMや動画生成AIでは、Hugging Faceが中心です。 開発元が公式モデルを公開する場所として使われるほか、コミュニティが作った量子化版やFine-tune、LoRAなども多数配布されています。モデルを探すときは、まずHugging Faceを見ることが多いです。
画像生成AIでは、Hugging Faceに加えてCivitaiも非常に大きな存在です。 Civitaiは画像生成モデルに特化したコミュニティサイトで、特定の画風・キャラクター・用途に特化した派生モデルが大量に公開されています。実際の生成例を見ながらモデルを探せるのも特徴です。
GitHubは、モデルそのものよりも実行方法や高速化技術が集まる場所です。 モデルを動かすためのプログラムや、GPUメモリを節約する方法、高速化、対応ツールなどの開発が行われています。
「オープンウェイト LLM」の計算式を詳しく見る。
LMArena(50%)
実際にユーザーがモデルを使った際の回答品質を評価します。クラウドと少し違うのは、データ量の問題です。多くのモデルのベンチマークがあるものの比重を多くしています。
- Text(35%)一般的な文章での総合力です。質問への回答、説明、要約、推論など、普段LLMを使うときの幅広いテキスト能力を評価します。
- Text Coding(10%)プログラミングに関する回答能力です。コード生成や修正、技術的な質問への回答など、テキストベースのコーディング能力を評価します。
- WebDev(5%)WebサイトやWebアプリを作る能力です。指示に沿ってUIやレイアウト、機能を実装し、実際に使える形へ仕上げる能力を評価します。
企業公式ベンチマーク(25%)
各社がモデル発表時などに公開している主要ベンチマークの結果を使い、LMArenaだけでは捉えにくい推論・数学・コーディングなどの能力を補います。ただ、他社に勝っている見栄えの良いベンチだけを公開する企業もあるので注意です。
Parameter Efficiency(25%)
モデルの性能だけでなく、「その性能をどれくらいのモデル規模で実現しているか」も評価します。
DenseモデルとMoEモデルを同じ土台で比較するため、総パラメータ数とActive Parametersの両方から「実効パラメータ数」を計算します。
実効パラメータ数 = √(総パラメータ数 × Active Parameters)
この実効パラメータ数で企業公式ベンチマークから算出した性能スコアを割り、モデル規模に対してどれだけ高い性能を実現しているかを評価します。
同程度の性能であれば、より少ないパラメータで高い能力を実現しているモデルを高く評価します。
Local / Open-weight Chimatome Score — 全24モデル
| Rank | Model | パラメータ(Total/Active) | 開発元 | 知まとめスコア |
|---|---|---|---|---|
| 1 | Kimi K3 | 2.8T/104B | Moonshot AI | 87.19 |
| 2 | GLM-5.3 Flash | 320B/18B | Z.ai | 79.81 |
| 3 | Qwen3.8-27B | 27B Dense | Alibaba | 76.41 |
| 4 | Hy3 | 295B/21B | Tencent | 75.64 |
| 5 | Qwen3.6-35B-A3B | 35B/3B | Alibaba | 74.30 |
| 6 | Gemma 4 26B-A4B | 25.2B/3.8B | 71.54 | |
| 7 | Muse Glimmer | 29.6B Dense | Meta | 70.71 |
| 8 | GLM-5.1 | 744B/40B | Z.ai | 70.14 |
| 9 | DeepSeek V4 Pro 0813 | 1.7T/49B | DeepSeek | 69.83 |
| 10 | Qwen3.6-27B | 27B Dense | Alibaba | 69.13 |
| 11 | MiniMax M3 | 428B/23B | MiniMax | 69.06 |
| 12 | MiMo V2.5 Pro | 1.02T/42B | Xiaomi | 68.95 |
| 13 | DeepSeek V4 Flash 0731 | 284B/13B | DeepSeek | 68.85 |
| 14 | GLM-5.2 | 744B/40B | Z.ai | 68.56 |
| 15 | Gemma 4 31B | 30.7B Dense | 66.12 | |
| 16 | Inkling | 975B/41B | Thinking Machines Lab | 64.50 |
| 17 | Qwen3.5-397B-A17B | 397B/17B | Alibaba | 59.28 |
| 18 | Qwen3.5-122B-A10B | 122B/10B | Alibaba | 57.92 |
| 19 | NVIDIA Nemotron 3.5 Lightning 30B-A3B | 30B/3B | NVIDIA | 56.18 |
| 20 | Mistral Medium 3.5 128B | 128B Dense | Mistral AI | 54.23 |
| 21 | GPT-OSS-20B | 20.91B/3.61B | OpenAI | 52.54 |
| 22 | GPT-OSS-120B | 116.83B/5.13B | OpenAI | 52.30 |
| 23 | NVIDIA Nemotron 3 Ultra 550B-A55B | 550B/55B | NVIDIA | 48.82 |
| 24 | NVIDIA Nemotron 3 Super 120B-A12B | 120B/12B | NVIDIA | 37.96 |
Kimi K3は、クラウドLLMにも競える強いモデルなのですが、現実的に個人が利用するのはほぼ無理です。この2.8兆パラメータにもかかわらず、かなり大差で1位なのは流石の性能だと思います。
Kimi K3運用したい方向け(ほぼ無理)
Kimi K3を公式に近い品質で自前運用するには、最低約1.56TBをメモリに乗せて運用する必要があるため、大規模なAI向けハードウェアが必要です。ここで必要なのは、一般的なPCで容量を増やしやすいCPU用メモリとは少し違います。高速な推論を行うには、GPUのVRAMや、DGX SparkのようなCPUとGPUが高速に共有できるUnified Memoryなど、AI計算向けの高速メモリにモデルを載せる必要があります。
現実的な構成としては、
- DGX Spark 128GBを16台接続:約1,400万円前後
- DGX B300(B300 288GBGPU×8):約4,800万〜5,600万円前後
といった選択肢があります。
個人でも16台のDGX Spark(1個100万円前後)を束ねてKimi K3を動かした例もあり、速度(B300×8の5分の1くらい)を妥協すれば、1,000万円台まで費用を下げることも可能です。
一見高いように見えますが、2.8兆パラメータ級の最先端モデルを自分で所有し、外部APIに依存せず好きなデータを入れて30並列前後で動かせる環境として考えると、意外と現実的な価格でもあります。
また、来年、再来年には、Fable・Astraレベルのモデルがこのくらいのパラメータで実現する可能性もあり、計算資源不足によってさらに価格が高くなっていく事も想像できます。個人では厳しくとも、法人や研究組織では選択肢に入ってくるのではないでしょうか。
一方、GLM-5.3 Flashは、個人でも頑張れば現実的に扱える射程に入ります。標準的な8bit級では300GBを超えるモデルですが、4bit級のNVFP4へ量子化すると約204GBまで小さくできます。
そのため、128GBのDGX Sparkを2台接続すれば、4bit版のGLM-5.3 Flashをモデル全体ごとメモリに載せることが可能です。実際に2台のDGX Sparkで約20〜30 tokens/sで動かした例もあります。
Kimi K3の公式MXFP4が約1.56TB必要なのに対し、GLM-5.3 Flashは4bit量子化による性能低下を比較的小さく抑えながら約200GBまで縮小できるため、個人でも200万円強払えば利用可能です。
本命は、Qwen3.8-27Bです。Denseモデルなので推論時には27Bすべてを使いますが、それでもモデル規模そのものがかなり小さく、4bit量子化なら約13.5GBまで縮小できます。
Kimi K3やGLM-5.3 Flashのように「高性能だが専用の大型ハードウェアが必要」というモデルとは違い、Qwen3.8-27Bは一般向けGPUの価格帯まで降りてきます。
さらに、実際に利用できる人が多いためコミュニティも活発で、さまざまな量子化版や最適化モデルが公開されています。
そのため、単に必要なハードウェアが安いだけでなく、同じGPUでもより速く動かしたり、より少ないVRAMに収めたりするための選択肢が豊富です。
ローカルLLMでは、こうした「利用者の多さ」と「最適化の蓄積」も、実用性にかなり大きく影響します。
3. 画像生成 — クラウド品質はGPT Image 2が明確
次は画像生成AIです。
画像生成は単純に順位を決めるのが難しく、モデルによって写真、アニメ、デザイン、文字生成など得意分野にもかなり差があります。また、最近は画像をゼロから生成するだけでなく、既存画像を自然に編集できる能力も重要になっています。
LLMでは用途や価格帯によっておすすめがかなり分かれましたが、クラウド画像AIについては、純粋な総合品質を優先するならGPT Imageがまず第一候補になります。
「クラウド画像AI」の計算式を詳しく見る。
LMArena Text-to-Image(60%)
文章から新しい画像を生成する能力です。
ユーザーが入力したプロンプトに対して、構図・人物・物体・文字・画風などをどれだけ正確に反映しながら、品質の高い画像を生成できるかを評価します。
画像生成AIで最も基本となる能力なので、全体の60%と最も大きく評価しています。
LMArena Single Image Edit(40%)
既存の画像を入力し、指示した部分を編集する能力です。
たとえば「人物はそのままで服だけ変える」「背景だけ変更する」「この文字だけ書き換える」といった編集で、変更してほしい部分だけを正しく変え、それ以外をどれだけ維持できるかを評価します。
最近の画像AIは生成だけでなく編集用途でも使われることが増えているため、40%を割り当てています。
評価に2個しか使ってないのは、比較できるデータが少ないためです。LLMのように共通したモデルベンチマークが無いため、その分情報が少なくなってます。
Cloud Image Chimatome Score
| 順位 | Model | 開発元 | 知まとめスコア |
|---|---|---|---|
| 1 | GPT Image 2 | OpenAI | 100.00 |
| 2 | MAI Image 2.6 | Microsoft AI | 86.10 |
| 3 | Grok Imagine Image 2.0 | xAI | 86.09 |
| 4 | Reve 2.1 | Reve | 76.61 |
| 5 | Muse Image | Meta | 76.53 |
| 6 | Seedream 5.0 Pro | ByteDance | 71.83 |
| 7 | Gemini 3.1 Flash Image | 71.71 | |
| 8 | MAI Image 2.5 | Microsoft AI | 71.67 |
| 9 | Gemini 3.1 Flash Lite Image | 62.31 | |
| 10 | Luma Uni 1.1 Max | Luma AI | 55.39 |
| 11 | Qwen Image 2.0 Pro 2026-06-22 | Alibaba | 52.95 |
| 12 | Luma Uni 1.1 | Luma AI | 52.78 |
| 13 | Seedream 5.0 Lite | ByteDance | 45.69 |
| 14 | Wan2.7 Image Pro | Alibaba | 42.84 |
| 15 | Wan2.7 Image | Alibaba | 42.46 |
| 16 | FLUX.2 Dev | Black Forest Labs | 40.90 |
| 17 | FLUX.2 Klein 9B | Black Forest Labs | 33.29 |
| 18 | FLUX.2 Klein 4B | Black Forest Labs | 27.67 |
現在は、GPT Image 2がかなり明確にトップです。GPT Image 2を先頭に、MAI Image 2.6とGrok Imagine Image 2.0が86前後で続いています。
GPT Image 2.5もリリースされています。順当な進化であれば、1位2位がGPT系で占める形になります。
クラウドの上位モデルは、成人向けコンテンツ以外であれば汎用性が高く色々な画風、構図の画像を生成可能です。
ローカル画像AI — 性能と軽さのバランスで見る
クラウド画像AIと違って、ローカルではモデルの性能だけでなく「自分のPCで現実的に動かせるか」がかなり重要になります。そのため、大型で高品質なモデルがそのまま上位になるわけではありません。
また、モデルパラメータがクラウドより少ないため、モデルごとの得意不得意が大きいです。写真、アニメ、イラスト、デザイン、文字生成など、作りたい画像によって最適なモデルは変わります。ある程度汎用性はあるのですが、それぞれが特化型モデルのようなイメージです。
そのためローカル画像AIでは、ランキング上位をそのまま選ぶというより、自分のGPUで動く範囲から、作りたい画像に合うモデルを選ぶのがおすすめです。
「ローカル画像AI」の計算式を詳しく見る。
LMArena Text-to-Image(70%)
文章から画像を生成する能力です。
同じプロンプトに対して複数のモデルが生成した画像をユーザーが比較し、どちらの画像が良いかを評価したLMArenaの結果を使っています。画像の綺麗さだけではなく、プロンプトへの忠実さ、構図、人物や物体の自然さ、文字生成などを含めた総合的な画像生成能力です。
ローカル画像AIでも、まず生成される画像の品質を最も重視したいため、全体の70%を割り当てています。
Model Size(30%)
モデルパラメータの大きさです。ローカルAIは自分のPCでモデルそのものを動かすため、モデルが大きくなるほど必要なGPUメモリや計算資源も増える傾向があります。
そのため、同じくらい高品質な画像を作れるのであれば、より小さなモデルを高く評価しています。ただし、小さいモデルが有利になりすぎないよう、パラメータ数をそのまま反比例させるのではなく、差を緩やかにする計算式を使っています。
Local Image Chimatome Score — 全11モデル / current 2026-09-04
| 順位 | Model | パラメータ | 開発元 | 知まとめスコア |
|---|---|---|---|---|
| 1 | Ideogram 4.0 | 9.3B | Ideogram | 56.65 |
| 2 | HiDream O1 Image | 8B | HiDream.ai | 46.34 |
| 3 | FLUX.2 Klein 4B | 4B | Black Forest Labs | 46.31 |
| 4 | Z-Image Turbo | 6B | Alibaba / Tongyi-MAI | 45.84 |
| 5 | Krea 2 Turbo | 12B | Krea | 41.52 |
| 6 | FLUX.2 Klein 9B | 9B | Black Forest Labs | 39.93 |
| 7 | Qwen Image 2512 | 20B | Alibaba | 39.39 |
| 8 | FLUX.2 Dev | 32B | Black Forest Labs | 39.23 |
| 9 | Cosmos3 Super Text2Image | 64B | NVIDIA | 37.46 |
| 10 | Hunyuan Image 3.0 | 80B total / 13B active | Tencent | 36.00 |
| 11 | GLM-Image | 16B(9B+7B) | Z.ai | 29.72 |
Ideogram 4.0が先頭です。Ideogram 4.0は9.3Bのモデルで、実際にRTX 5060 Ti 16GBで動かした例があり、8bit版では1枚あたり約78〜90秒、さらに軽量な4bit版では約67秒で生成されています。
つまりIdeogram 4.0は、RTX 4090や5090のような最高級GPUが必須というモデルではなく、より多くの人が持っている16GB VRAMのRTX 5060 Tiクラスでも現実的に利用できます。
また、量子化形式や解像度、step数(画像を完成させるまでの処理回数)によって生成時間も大きく変わります。
FLUX.2 Klein 4Bは、名前の通り4Bとかなり小さいモデルです。純粋な画像品質だけを見ると上位ではありませんが、必要な計算資源が少なく、誰でも扱いやすいことから総合では3位まで上がっています。
一番スコア低いGLM-imageですが、そこまで悪いわけではありません。公式サイトで画像を確認できます。
あと、ローカル画像生成をやる大きな理由として、成人向けコンテンツの作成があります。成人向けに特化されたモデルは無数にあり、コミュニティも成熟しているので、気になる人は調べて見てください。
ただ、制作したものにもよりますが、ネットに上げたりすると、捕まるケースもあるのでそこら辺は注意してください。
成人向けに特化したモデルもある
ローカル画像AIには、成人向け表現に特化した派生モデルも数多く公開されています。
LLMにも、安全機能や出力制限を取り除いた「無検閲モデル」というものがあり、危ない使い方をする事が出来ます。しかし、成人向け画像モデルでは、単に制限を外すだけではなく、成人向けの画像を使って追加学習し、その表現自体を得意にしたモデルが多く存在します。
代表的なのが、Stable Diffusion XLという公式モデルをベースにしたPony Diffusion系です。アニメ・イラスト系を中心に幅広い表現を追加学習しており、そこからさらに実写寄り、特定の画風、成人向けなどに調整された派生モデルが多数作られています。
モデル全体を追加学習する「Fine-tune」のほかに、既存モデルへ特定の画風や表現だけを追加する「LoRA」もよく使われます。
Ideogram 4のような比較的新しいモデルにも、すでに成人向け表現へ追加学習した非公式の派生モデルが登場しています。ただし、PonyやStable Diffusion系ほど派生モデルや周辺ツールが成熟しているわけではありません。
また、こうした派生モデルを商用利用する場合は注意が必要です。ベースモデルと派生モデルでライセンス条件が異なることもあるため、利用前にそれぞれのライセンスを確認する必要があります。
4. 動画生成 — 品質+価格で見る
動画生成AIは、モデルによって映像の自然さ、指示への忠実さ、動きの安定性にかなり差があります。
さらに画像生成と違い、数秒の動画を1本作るだけでも比較的コストが高いため、品質だけでなく生成にかかる価格も重要です。
「動画生成AI」の計算式を詳しく見る。
動画生成AIは、動画の品質を中心に評価し、最後に価格による補正を加えて順位を決めています。
Text-to-Video(40%) 文章から動画を生成する能力です。プロンプトの内容をどれだけ正確に映像へ反映できるか、動きが自然か、映像全体が破綻していないかなどを評価します。
Image-to-Video(40%) 1枚の画像から動画を作る能力です。元画像の人物や構図を維持しながら、自然な動きを加えられるかを評価します。現在の動画生成AIでは非常によく使われる機能なので、Text-to-Videoと同じ40%にしています。
Video Editing(20%) すでにある動画を指示に沿って編集する能力です。被写体や背景を変更したり、映像の内容を保ったまま一部だけを書き換えたりできるかを評価します。
価格による補正
動画生成は画像生成よりも1回あたりの料金が高いため、品質だけでなく価格も重要です。
各モデルの料金を5秒・720pの動画を1本生成する場合にそろえて比較し、比較対象モデルの中で安いモデルには加点、高いモデルには減点します。
Video Chimatome Score — 品質+価格 / 5秒720p基準
| 暫定順 | Model | 開発元 | 知まとめスコア | 5秒基準価格 |
|---|---|---|---|---|
| 1 | Gemini Omni 1.1 Flash | 97.41 | $0.50 | |
| 2 | Wan 3.0 | Alibaba | 96.13 | $0.35 |
| 3 | MiniMax H3 | MiniMax | 93.04 | $0.40 |
| 4 | Gemini Omni Flash | 92.89 | $0.50 | |
| 5 | Seedance 2.5 | ByteDance | 89.11 | $2.310375 |
| 6 | Seedance 2.0 | ByteDance | 87.51 | $1.515 |
| 7 | Grok Imagine Video 1.5 | xAI | 83.25 | $0.70 |
| 8 | Wan2.7 I2V | Alibaba | 78.72 | $0.50 |
| 9 | HappyHorse 1.0 | HappyHorse | 77.94 | $0.49 |
| 10 | Vidu Q3 Pro | ShengShu Technology | 63.18 | $0.50 |
| 11 | Wan2.7 T2V | Alibaba | 54.35 | $0.50 |
| 12 | PixVerse V5.6 | AISphere / PixVerse | 41.52 | $0.45 |
| 13 | Vidu Q2 Turbo | ShengShu Technology | 40.21 | $0.20 |
| 14 | P-Video | Pruna | 37.33 | $0.10 |
| 15 | Hailuo 2.3 | MiniMax | 37.13 | $0.22 |
| 16 | Vidu Q2 Pro | ShengShu Technology | 35.90 | $0.275 |
| 17 | Runway Gen 4.5 | Runway | 30.96 | $0.60 |
| 18 | Hunyuan Video 1.5 | Tencent | 29.29 | $0.23 |
| 19 | Runway Gen4 Turbo | Runway | 19.47 | $0.25 |
Googleがトップです。
Seedance 2.5は動画品質では高いものの、基準価格が高いため総合スコアでは下がります。
ローカル動画はMiniMax H3が現状の基準点
Local Video Chimatome Scoreは、動画品質にモデル規模のcompactnessを加えます。ここもVRAMや生成秒数の実測ランキングではありません。
「ローカル動画AI」の計算式を詳しく見る。
ローカル動画AIでは、動画そのものの品質だけでなく、個人のPCで動かしやすいモデルの軽さも重要です。
動画品質(70%)
動画品質は、クラウド版と同じ3項目から計算します。
- Text-to-Video:40%
- Image-to-Video:40%
- Video Editing:20%
文章から動画を作る能力、画像から自然な動画を作る能力、既存動画を編集する能力をまとめて評価します。
Model Size(30%)
3回目ですが、ローカルAIでは、モデルが大きいほど必要なメモリやハードウェアも大きくなりやすいため、モデルのパラメータ数も評価に加えています。
小さいモデルほど高く評価しますが、単純に「半分のサイズなら2倍の評価」にはしていません。モデルサイズの影響を緩やかにすることで、軽さだけで低品質なモデルが上位にならないようにしています。
つまり、高品質な動画を作れることを最優先しつつ、同程度の性能なら、より小さくローカルで扱いやすいモデルを高く評価する仕組みです。
Local Video Chimatome Score — current 2026-09-05
| Rank | Model | パラメータ | 開発元 | 知まとめスコア |
|---|---|---|---|---|
| 1 | MiniMax H3 | 33B | MiniMax | 75.16 |
| 2 | Kandinsky 5.0 T2V Lite | 2B | Sber AI | 44.07 |
| 3 | Hunyuan Video 1.5 | 8.3B | Tencent | 39.80 |
| 4 | Kandinsky 5.0 T2V Pro | 19B | Sber AI | 30.96 |
| 5 | Mochi v1 | 10B | Genmo | 29.19 |
かなり少ないですが、今回のランキングに掲載しているのは、比較に必要な公開ベンチマークが揃っているモデルに絞っているためです。
ローカルで利用できる動画生成AIが5種類しかないわけではありません。現在はほかにも、LTX-2.5(22B)、Wan2.2(27B)、SkyReels V3(14B / 19B)、Open-Sora 2.0(11B)、CogVideoX1.5(5B)など、有力なオープンウェイトモデルが公開されています。ローカル動画AIは画像生成やLLMと比べるとまだ市場が若く、新しいモデルの登場も速いため、今後ランキング対象は増えていく予定です。 スコアを見ればわかる通り、今のところローカル動画は、MiniMaxH3一択です。MiniMax H3は33Bと大型ですが、量子化やメモリへのオフロードを使えば一般向けGPUでも動かせます。 実際にRTX 5060 Ti 16GBで動かした例では、1024×576・約5秒の音声付き動画を、軽量なTurbo設定で約3分、通常設定では約6分20秒で生成しています。
動画生成時間は解像度、動画の長さ、step数、量子化方式などで大きく変わります。特にH3は設定による速度差が非常に大きいため、GPUだけを見て単純に比較することはできません。
H3にも成人向けの派生モデルが存在します。
5. 音声AI — 総合Scoreを作らず、用途別に選ぶ
音声AIは、LLMや画像生成のように1つの総合Scoreで順位を決めていません。
一口に音声AIといっても、文章を自然に読み上げるTTS、音声を文字にするSTT、人間とリアルタイムに会話する音声対話、音楽生成では求められる能力が大きく異なるためです。
自然な声で文章を読むのが得意なモデルが、音声認識や会話でも強いとは限りません。そのため、ここでは用途ごとに現在の有力モデルを見ていきます。
音声AI — 用途別の現在のおすすめ
| 用途 | おすすめ | 特徴 |
|---|---|---|
| 自然な読み上げ | Sonic 3.6 | 声そのものの自然さや好みを含めた比較で高評価 |
| 日本語の読み上げ | Gemini 3.1 Flash TTS | 日本語TTSの比較でトップ。Eleven v3などが続く |
| 英語の文字起こし | Fun-Realtime-ASR-preview | 英語の音声認識で高精度 |
| 日本語の文字起こし | MAI-Transcribe-1.5 / Scribe v2 / Gemini 3.1 Pro | 3モデルがかなり近く、明確な1位を決めにくい |
| 自然な音声会話 | Gemini 3.1 Flash Live Preview Minimal | 人間が実際に会話したときの好みで高評価 |
| 音声Agent・タスク成功 | GPT-Realtime-2.1 High | 会話しながらタスクを完了する能力が強い |
| 音楽生成・8/25 snapshot | Suno v5.5 | 直近の比較では歌入り・インストの両方でトップ級 |
特に面白いのが、音声会話では「自然に話せるAI」と「仕事を任せられるAI」でトップが違うことです。
Gemini 3.1 Flash Liveは、人間が実際に会話してどちらを好むかという評価で強く、自然な会話相手として優秀です。
一方、GPT-Realtime-2.1は、予約や問い合わせなどの会話を通して目的を達成する能力が高く、音声Agentとして使う場合はこちらが有力です。
TTSでも同じで、英語を含めた声の自然さではSonic 3.6が強い一方、日本語に限定するとGemini 3.1 Flash TTSがトップになります。
音楽生成ではSuno v5.5が高い評価を得ています。ただし、Lyria 3.5やMiniMax Music 3.0など新しいモデルも登場しており、最新世代をすべて同じ条件で比較できているわけではありません。
ローカルで動かせる音声AIも増えている
音声AIにも、PCにダウンロードして動かせるオープンウェイトモデルがあります。
代表的なのが、AlibabaのQwen3-TTSです。0.6Bと1.7Bという比較的小型のモデルが公開されており、日本語を含む多言語の読み上げに加え、数秒の音声から声を再現するVoice Cloneや、指定した特徴から声を作るVoice Designにも対応しています。
音声を文字にするSTTでは、OpenAIが公開しているWhisper Large v3 Turboが代表的です。多言語の文字起こしに対応し、モデルをローカルに保存して利用できます。
さらに、Qwen3-Omniのように、マイクから入力された音声を理解して、そのまま音声で返答できるオープンウェイトモデルも登場しています。ローカル環境だけでリアルタイム音声アシスタントを構築することも可能です。
音楽生成ではACE-Step 1.5が公開されており、歌詞や曲調を指定して楽曲を生成できます。軽量化や高速化も進んでおり、一般向けGPUで音楽生成を動かせる環境も整いつつあります。
このように音声AIでも、LLMや画像生成と同じように、クラウドサービスを使う方法と、オープンウェイトモデルを自分のPCで動かす方法の両方が選べるようになっています。
あと、成人向けのオープンウェイト音声モデルも色々あります。特にローカルTTSでは、通常モデルを成人向け音声データで追加学習し、通常の読み上げでは扱いにくい声や息遣いまで生成できる派生モデルが公開されているそうです。
6. ロボティクス / Physical AI — 「AIの頭脳」と「身体」を分けて見る
ロボティクスもランキングは作れるほどのデータは無かったです。
ロボットの性能はAIモデルだけで決まるわけではなく、カメラや触覚センサー、モーター、手の構造、移動能力、制御ソフトウェアなど、実際の身体性能にも大きく左右されます。
例えば同じAIモデルを使っていても、搭載するロボットが変われば、歩ける速度や持てる重量、細かな作業の精度まで変わります。
現在特に重要になっているのが、映像や言葉を理解し、そのままロボットの動作につなげるVLA(Vision-Language-Action)モデルです。
比較
| 分野 | 代表例 | 特徴 |
|---|---|---|
| 汎用ロボットAI | Gemini Robotics 2 | Google DeepMindの最新VLA。物体操作に加え、歩行を含む全身制御や複数ロボットの協調にも対応 |
| ヒューマノイド | Helix 02 / Figure 03 | 映像から全身を直接制御。歩行しながら物を運ぶ、片付けるなど長時間の実作業を実演 |
| オープンウェイト | NVIDIA Isaac GR00T 1.7 | 3BのVLAモデル。重みが公開されており、独自ロボット向けに追加学習して利用可能 |
| Embodied AI | AgiBot GO-2 | 推論と実際の動作を一つのシステムに統合。大規模な実ロボットデータ、シミュレーション、学習基盤まで自社で構築 |
| 中国・高性能ヒューマノイド | Unitree G1 / H1-2 | 走行やバランスなど身体性能に強い中国大手。比較的入手しやすい実機として研究用途でも広く使われる |
| 中国・産業用ヒューマノイド | UBTECH Walker S2 | 工場での長時間稼働を重視。自律バッテリー交換や複数ロボット協調のCo-Agentを搭載し、量産・納入段階に入っている |
表を見ると、現在のロボティクスは単純に「どのロボットが一番強いか」という競争ではなく、各社でアプローチが場所がかなり違います。
Google DeepMindやFigureは、ロボットが初めて見る物体や新しい指示にも対応できる、汎用的なロボットAIの開発を進めています。人間が自然な言葉で指示すると、周囲を見て状況を判断し、そのまま身体を動かして仕事をこなす方向です。
一方、NVIDIAは完成したヒューマノイドそのものを作るというより、さまざまなメーカーが使えるロボットAIの共通基盤を狙っています。Isaac GR00Tのようなモデルに加え、シミュレーションや学習環境までまとめて提供し、各社が自分たちのロボットへAIを組み込みやすくしています。
中国勢は「AI」だけでなく実機と量産が強い
中国では、AgiBot、Unitree、UBTECHなど多数の企業がヒューマノイドを開発しています。
AgiBotはVLAなどのAIモデルに加えて、大量のロボットデータを収集する仕組みやシミュレーション環境まで構築しており、ロボットの頭脳を大量の実世界データから学習させる方向を強く進めています。
Unitreeは、AIモデルそのものだけでなく、走る、跳ぶ、バランスを取るといったロボットの身体性能で存在感があります。比較的安価な実機も販売しているため、研究機関や開発者が実際のロボットを入手してAIを試せる点も特徴です。
公式サイトにUnitree G1のデモ動画が色々あがってます。
UBTECHは、研究デモよりも工場などで実際に働くロボットを重視しています。Walkerシリーズでは、自動車工場を中心に搬送や部品取り扱いなどへの導入が進められており、産業現場でヒューマノイドを実用化する競争を進めています。
ロボットAIも「基盤モデル」の時代へ
これまでロボットは、工場の決められた場所で決められた動きを繰り返す使い方が中心でした。しかしVLAの登場によって、現在は「このコップを棚に戻して」のような言葉を理解し、カメラで周囲を確認しながら、自分で必要な動きを組み立てる方向へ進んでいます。
LLMが文章ごとに専用プログラムを書く必要を減らしたように、ロボティクスでも、作業ごとにすべての動きを人間がプログラムする方式から、1つの汎用モデルに多くの仕事を学習させる方式へ移りつつあります。ただし、現実世界では物を落としたり、人にぶつかったりする可能性があります。
そのため、単にAIモデルが賢いだけでは足りず、センサー、制御、安全機構、身体性能まで含めたシステム全体の完成度が重要になります。ロボティクスは、LLMのように「モデル単体の性能」を競う段階から、AIの頭脳と現実の身体をどこまで一体化できるかを競う段階に入り始めています。
7. まとめ — 「一番強いAI」ではなく、用途ごとに選ぶ時代
ここまでLLM、画像、動画、音声、ロボティクスまで見てきましたが、現在のAIには「これを選べば全部一番」というモデルはありません。
コーディングに強いAI、文章に強いAI、画像生成に強いAI、動画生成に強いAI、自然な音声で会話できるAIなど、それぞれ得意な領域が分かれています。同じ分野の中でも、品質を優先するのか、価格を優先するのか、ローカルで動かしたいのかによって最適な選択は変わります。
一方で、大きな流れとしては共通しています。
クラウドAIでは巨大な計算資源を使った高性能モデルが競争を続ける一方、オープンウェイトではモデルの小型化や量子化が進み、これまでデータセンターでしか扱えなかった性能が個人のPCまで降りてきています。
そして次の大きな競争になりつつあるのがPhysical AIです。
AIは文章、画像、動画、音声というデジタル空間だけでなく、ロボットの身体を通して現実世界へ出始めています。
個人的な予想ですが、自動運転の流れを踏襲するなら、ヒューマノイドロボットは閾値を超えてから一気に世の中に浸透する可能性は高いと見ています。
LLMは比較的早い段階から、文章作成や検索、コーディングなど、一般の人でもすぐに価値を実感できる実用域に達しました。そのため、モデルが少し賢くなるだけでも変化が見えやすく、進歩の速さも感じやすい分野です。
一方、ロボティクスは少し事情が違います。
「物をつかめる」「歩ける」「指示を理解できる」といった個別の能力が向上しても、それだけでは人間の仕事を任せられません。長時間安定して動き、失敗が少なく、人の近くでも安全で、さらに人間より低いコストで運用できるところまで到達して初めて、本格的な導入が始まります。
自動運転も、完全無人で走れるようになった瞬間に普及したわけではありません。安全性や運用体制、規制、コストなど複数の条件が揃った地域から、利用回数やサービスエリアが急速に拡大しました。
ヒューマノイドも同じように、外から見ると長い間「研究デモが少しずつ良くなっている」ように見えながら、実用に必要な条件が揃った瞬間に、工場や物流、店舗、家庭へ一気に広がる可能性があります。
ただ、米中を中心に自動運転が交通手段の1つとして普及している中、何故かまだ実証実験を行っている日本では、ヒューマノイドロボットを見る日も遠いのかもしれません。残念です。
この記事では、その時点で公開されているベンチマーク、価格などをもとに、評価してきました。
今後も主要モデルの更新や新モデルの登場に合わせて、比較データを随時更新していきます。