クラウドAIとローカルAIの違い:色々なAIの仕組み
ChatGPTと何が違う?重み・GPU・価格から「自分のPCで動かすAI」を理解する
最終更新 2026.09.17
目次21項目開く
ChatGPTを開けば、ブラウザですぐAIと会話できます。スマホのアプリから使うことも日常的になりました。そのため普段はあまり意識しませんが、画面の向こう側では、巨大なAIモデルと、それを読み込んで動かすソフト、そして無数のGPUなどの計算機が24時間体制で動いています。
一方で、AI開発者や、機密性を重視しながらAIを利用したい法人ではローカルAIという選択肢もあり、最近勢いが増してきています。ローカルAIの本質は、ネット接続の有無ではなく、画面の向こう側に隠れていた「AIを成立させる要素」を、どこまで自分の手元へ持ってくるかという所有と運用の違いです。
この記事では、クラウドAIとローカルAIの違いを説明しつつ、普段使っているAIサービスがどこに該当するかなど、割と曖昧な部分にフォーカスして解説していきます。
30秒でわかる: Cloud / Localは二択ではない
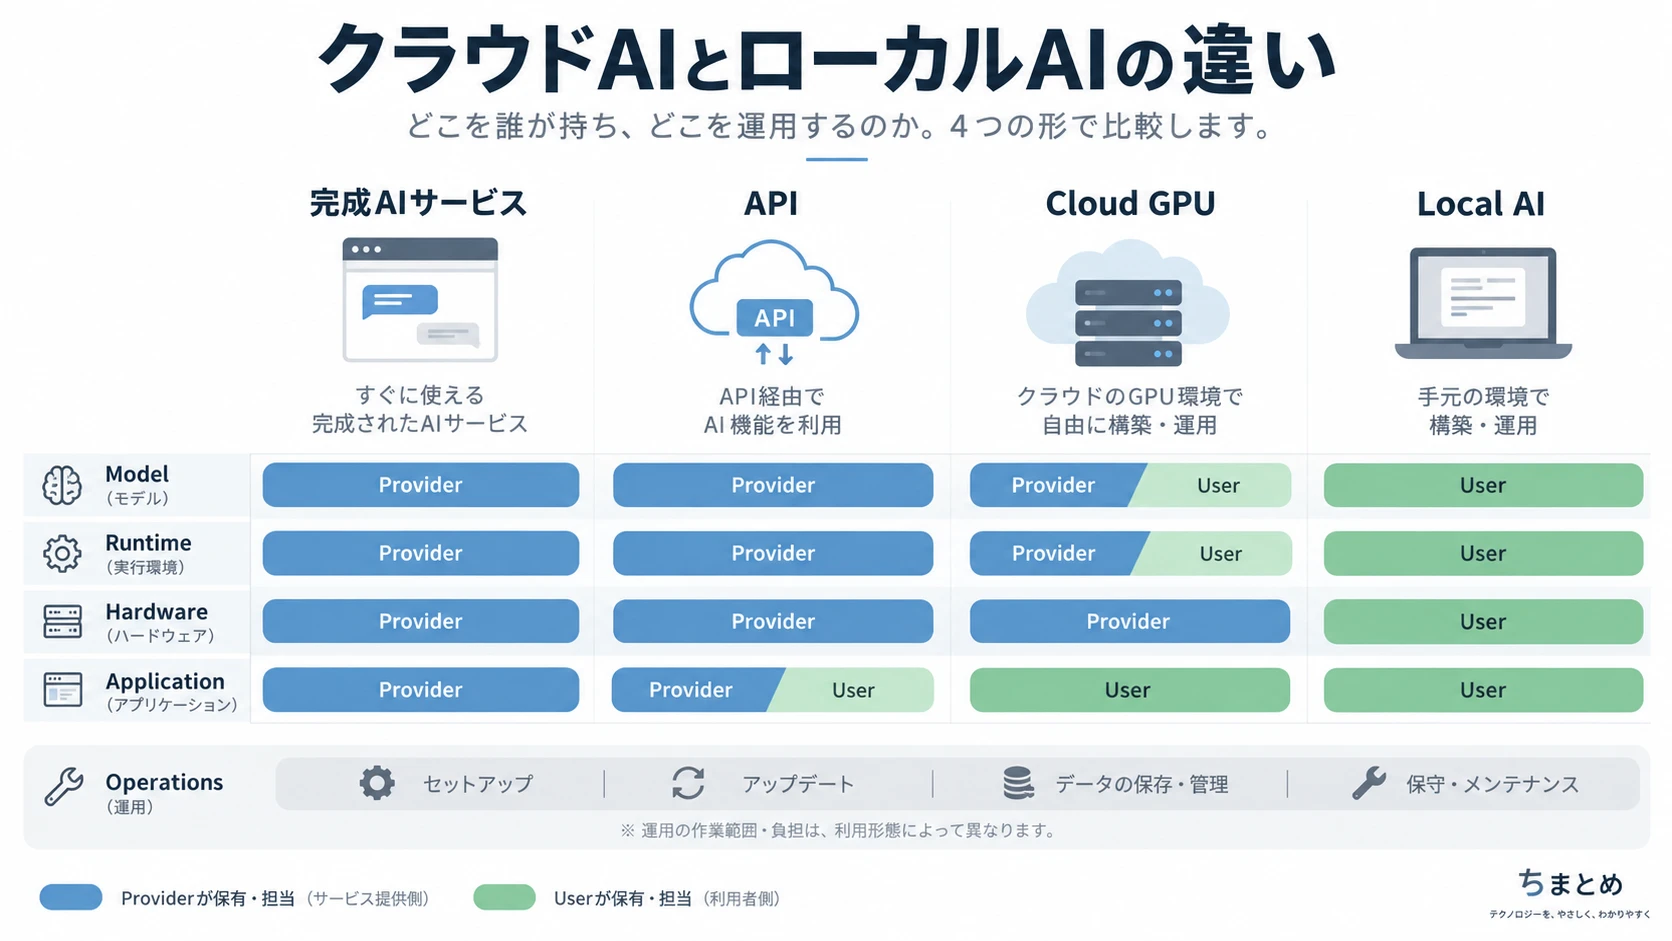
違いは、AIを成立させる要素を誰が持つか
まず、クラウドとローカルで2分するよりも、上の4つで分けると整理しやすいです。
AIを動かすには、モデル本体(weights)、実行ソフト(runtime)、計算機(hardware)、操作画面(application)、そしてそれらを保守する**運用(operations)**が必要です。
-
ChatGPTのような完成AIサービスでは、ほぼすべてを事業者が持ちます。
-
APIではモデルや計算機を事業者に任せ、ユーザーはどこでAIを動かすかを決めることが出来ます。自分のWebアプリなどで使いたい場合はこれです。
-
クラウドGPUでは遠隔のGPU計算機を借り、動かすモデルやソフトは自分で選びます。自分で作ったAIを試すことも可能です。
-
ローカルAIでは、モデルファイルから計算機まですべてを自分の手元へ持ってくる事で、法律の範囲内であれば自由に何でもできます。
このように、AIの使い方には責任の置き場所が異なる複数のグラデーションがあります。
これを整理したものが、次の**責任境界の地図(Ownership map)**です。
AIの利用形態ごとの責任境界(Ownership map)
| 形態 | Model | Runtime / Serving | Hardware | Application / Interface | Operations(保守・運用) |
|---|---|---|---|---|---|
| 完成AIサービス | 事業者 | 事業者 | 事業者 | 事業者中心 | 事業者中心 |
| API | 事業者 | 事業者 | 事業者 | 利用者 | 事業者中心(アプリ側は利用者) |
| クラウドGPU | 利用者 | 利用者 | 事業者から借りる | 利用者 | 利用者 + 事業者 |
| ローカルAI | 利用者 | 利用者 | 利用者 | 利用者 | 利用者 |
この表で最も大切なのは、右端の**Operations(運用)**です。これはソフトのインストール、ドライバ更新、故障対応、ストレージ管理、ネットワーク設定などを誰が引き受けるかという横断的な責任です。
AIによって誰でも簡単にプログラムが書けるようになりましたが、この保守・運用までをAIに任せるのはなかなか難しいです。だからこそサービス事業者は、みんなすごいんですよね。
ChatGPTの裏側には何がある?
では、「AIを自分のPCへ持ってくる」と言ったとき、具体的には何を持ってくるのでしょうか。
これを理解するには、1回の会話や質問に対して、AIがどうやって答えを作っているかという**推論の処理フロー(Execution flow)**を見るのが一番早いです。
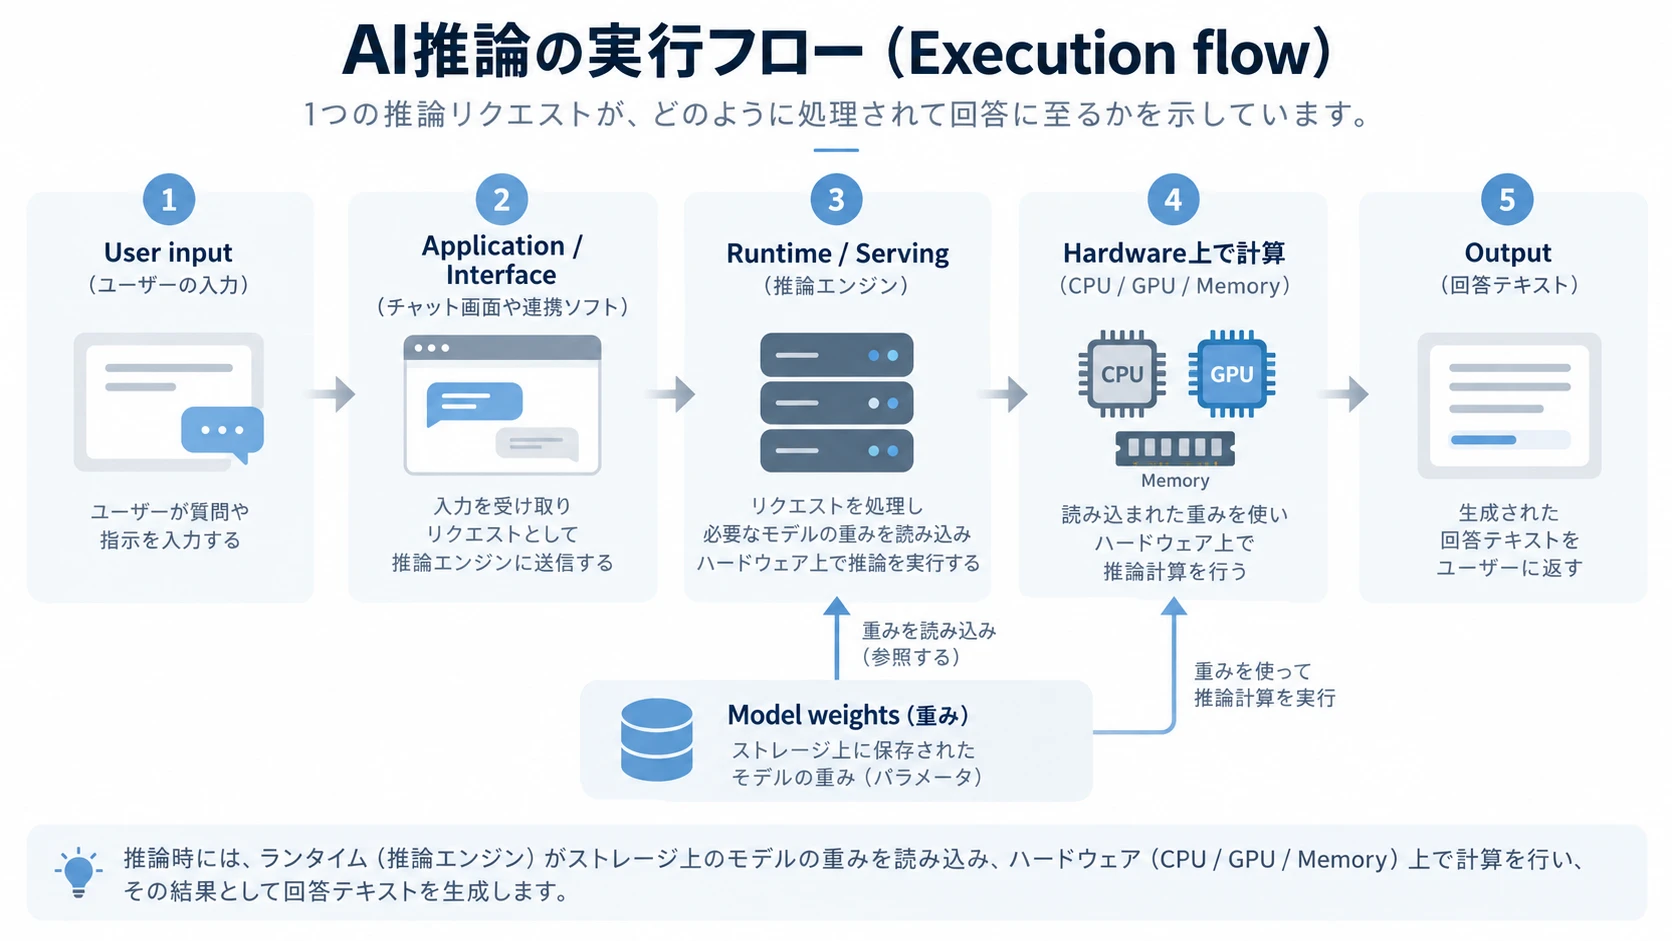
このフローには、大きく4つの構成要素が登場します。
- Application / Interface(アプリ・操作画面)ユーザーが文字を入力し、返ってきた答えを表示する画面です。ブラウザ上のチャット画面、デスクトップアプリ、あるいは自作のスクリプトなどがこれに当たります。
- Runtime(ランタイム / 実行ソフト)入力された文章を受け取り、モデルデータを読み込んで、PCの計算機へ「どう計算するか」を指示する制御ソフトです。ローカルAIでよく耳にするOllamaやllama.cpp、vLLMなどは、AIモデルそのものの名前ではなく、このRuntimeに当たります。
- Model weights(モデルの重み)AIが膨大なデータを学習した結果として獲得した「巨大な数値の塊」です。AIの知識や能力の実体はこの数値データに詰まっています。ローカルAIを始めるときに、インターネットから数GB〜数百GBのファイルをダウンロードしますが、その落としてくるファイルこそがこのweightsです。
- Hardware(ハードウェア / 計算資源)実際に膨大な掛け算や足し算を実行するCPU、GPU、そして計算データを保持するメインメモリ(RAM)やビデオメモリ(VRAM)です。
ここで注意したいのは、weightsはRuntimeとHardwareの間を流れる処理装置ではないという点です。Runtimeというソフトが、weightsという巨大な設計図・辞書を参照しながら、GPUなどのハードウェア上で猛烈な計算を行い、その結果が文字として出力されます。
ChatGPTを使うときは、このApplicationからHardware、そして日々の運用保守まで、すべてOpenAIのデータセンター側で完結しています。ローカルAIをやるという事は、この中のRuntime、Hardware、そして数GB以上あるweightsファイルを自分の手元に揃えて実行する、という意味になります。
4つの使い方を実物レベルで分ける
先ほどのOwnership mapで見た4つの形態は、実際に使おうとしたときの操作や体験がまったく異なります。画面やコードのレベルでどう違うのかを具体的に分けてみましょう。
1. 完成AIサービス
ChatGPT、Claude、GeminiなどのWebサイトや公式アプリです。 アカウントを作成してログインすれば、その場ですぐ最高峰のAIと会話できます。スマホアプリ、音声会話、Web検索、画像生成、ファイル読み込みなどが最初から一体化しています。モデルのダウンロードやパソコンの性能を気にする必要は一切ありません。
2. API
OpenAI APIやAnthropic APIのように、自分が作ったプログラムやWebサービスからAIを呼び出す使い方です。 画面は自分で作りますが、裏側のAIモデルの読み込みやGPUサーバーの管理はすべて事業者が引き受けます。「質問文をネット経由で送ると、答えがテキストで返ってくる」という窓口(エンドポイント)だけを利用し、使ったトークン(文字数)の分だけ従量課金で支払います。
3. クラウドGPU
RunPod、Vast.aiなどのサービスを使い、ネット越しにGPUを積んだ遠隔のパソコンを時間単位で借りる形態です。 ここは少し誤解しやすいですが、クラウドGPUは「高機能なChatGPT」のような完成品ではありません。借りられるのは、Linuxなどが動くまっさらなGPU計算機です。借りたあとに、自分でSSHやJupyterLabでログインし、好きなRuntime(vLLMやComfyUIなど)をインストールし、オープンモデルのweightsをダウンロードして動かします。 手元に高いGPUを買わなくても、大容量GPUを数時間だけ試せるのが特徴です。
クラウドGPUおすすめ比較【2026年】料金・使いやすさ・用途別に選ぶ
クラウドGPUで何を借りるのか、どのGPUが必要なのか、料金のどこを見るべきかを整理し、RunPod・Vast.ai・Lambdaなどから用途別に候補を絞ります。
ちまとめ
4. ローカルAI
自分のパソコンにRuntime(Ollamaなど)をインストールし、モデルファイルをローカルストレージにダウンロードして、自分のPCのCPUやGPUだけで推論を完結させる形態です。
では、「自分のPCでローカルAIを動かす」場合、実際にPCへ何を置くことになるのでしょうか。実際のモデルを例に見ていきます。
Local AIを物理的に見る: Gemma 3 12B
ローカルAIを具体的にイメージするために、Googleが公開しているオープンウェイトモデルGemma 3 12Bを例にします。
google/gemma-3-12b-it · Hugging Face
We’re on a journey to advance and democratize artificial intelligence through open source and open science.
huggingface.co

Gemma 3 12Bは、テキストだけでなく画像も理解できるマルチモーダル対応のモデルです。「12B」のBはBillion(10億)の略で、およそ**120億個のパラメータ(parameters)**を持っています。パラメータとは、AIが学習によって調整した内部の数値(重み)の数のことです。パラメータ数が多ければ必ず賢いとは限りませんが、モデルの規模や、動かすために必要なメモリの大きさを測る基準になります。
ローカル環境で広く使われているGGUFというファイル形式(llama.cppやOllamaなどで標準的に使われる形式)で配布されているファイルサイズを確認してみましょう。サイト開いて、モデル名の下のFile and versionsで見れます。量子化版は、PCだと右側、スマホだとちょっとスクロールしたQuantizationsって所です。
- f16版(元の精度に近い16bit形式): 約23.5GB
- Q4_K_M版(扱いやすく4bit相当へ軽量化した形式): 約7.3GB
この数字を見ただけでも、PCに何を保存するのかがはっきりします。ローカルAIを動かすとは、次の足し算を自分のPC上で組み立てることです。
Gemma 3 12B Q4 の重みファイル(約7.3GB)
+
Ollama や llama.cpp などのRuntime(実行ソフト)
+
PCのCPU / GPU と メモリ(RAM / VRAM)
+
必要に応じてチャット操作画面
=
自分のPCだけで会話できるローカルAI
7.3GBのファイルをSSDに置き、それをOllamaなどのソフトが読み込み、PCのメモリに展開してGPUで計算する。これだけで、ネット接続を完全に切断しても自分のPC上でAIが回答を生成し始めます。
ただし、ここで初心者が必ず引っかかる現実の摩擦があります。
もしGPUの専用メモリ(VRAM)に収まりきらない場合、PCのメインメモリ(システムRAM)へ一部の処理を逃がす「オフロード」という機能もあります。これを使えば8GBや12GBのPCでも動かすこと自体は可能です。ただし、GPU専用メモリに比べてメインメモリとCPUの間の通信速度は桁違いに遅いため、文字の出力速度がガクンと落ちるという制約を受けます。
量子化でなぜPCに入る?
ここで一つの疑問が浮かびます。Gemma 3 12Bの元のファイル(f16)は約23.5GBもあったのに、なぜQ4_K_M版では約7.3GBまで小さくなっているのでしょうか。
このサイズ縮小を可能にしているのが**量子化(Quantization)**という技術です。
モデルの重み(weights)は一つひとつの細かい数値です。通常、モデルの開発時や高精度な保存では、1つの数値を16bit(2バイト)の浮動小数点数で表現します。 単純に120億個(12B)の数値を16bitで持とうとすると、計算上は次のようになります。
120億 × 16bit(2バイト) = 240億バイト ≒ 約24GBこれが、元のf16ファイルが約23.5GBになる理由です。一般家庭のパソコンで「VRAM 24GB」を持つGPU(GeForce RTX 4090や5090など)を用意するのは、価格的にもかなりハードルが高いのが現実です。
そこで、重みの数値を「そこまで細かい桁数で持たなくても、多少丸めて4bit(0.5バイト)程度で表現しても言葉の意味や推論能力は大きく崩れないのではないか」と工夫したのが量子化です。 16bitから4bitへ落とせば、単純計算でデータ量は約4分の1になります。7.3GBという数字は、モデルの基本構造やメタデータを含めつつ、重みを4bit相当へ圧縮した結果です。
ここで注意したい境界線が2つあります。
- 数値を粗く丸めているため、わずかな精度の低下や回答品質のトレードオフが存在します。
- 量子化ファイルサイズ = 必要なGPUメモリではない。前述のとおり、7.3GBのファイルが小さくなったからといって、会話中の文脈を保持するためのメモリ領域まで4分の1になるわけではありません。
それでも、量子化のおかげで、本来なら業務用の大型サーバーでしか載らなかった規模のモデルが、一般向けのノートPCやデスクトップPCで実用的な速度で動くようになりました。
もっと大きくすると: Qwen3.8-27B
12Bクラスのモデルが一般向けPCで動くことは分かりました。では、もっと賢く、より長い文章を正確に扱えるモデルを求めると、ハードウェアの要求はどう跳ね上がるのでしょうか。
一段上の現実的なステップとして、Alibabaが開発したオープンモデルQwen3.8-27Bを見てみます。27Bなので、約270億パラメータを持つ大型モデルです。
Qwen/Qwen3.8-27B · Hugging Face
We’re on a journey to advance and democratize artificial intelligence through open source and open science.
huggingface.co

同じくggml-orgが公開しているGGUF形式のファイルサイズを確認します。
- BF16版(高精度な16bit形式): 約53.8GB
- Q4_K_M版(4bit量子化): 約19GB
4bitに量子化しても、ファイル単体で約19GBあります。
こうなると、16GB VRAMのグラフィックボードにはどう工夫しても重みファイル全体が入り切りません。ここで初めて、24GB〜32GBクラスのメモリ環境が現実的な検討ラインに入ってきます。
例えば、ハードウェア検証を行っているHardware Cornerの実測データでは、llama.cpp環境においてQwen3.8-27BのQ4_K SmallモデルをGPU上にすべて載せ、64Kトークン(日本語でおよそ数万文字)の文脈を保持して推論させた場合、VRAMの消費量は約22GBに達しています。24GB VRAMを持つGPUであればギリギリ一式を載せて実用速度で動かせますが、さらに文脈を伸ばしたり、別の画面ソフトを同時に開いたりするなら、32GB VRAMを持つGPUや、大容量のユニファイドメモリを持つMacの方が圧倒的に安全に余裕を確保できます。
必要なハードウェアを決める判断の流れは、常に次の順番になります。
動かしたいモデルの選定
↓
精度・量子化方式の決定(16bitか、4bit量子化かなど)
↓
想定する文脈長・作業内容・同時処理数の決定
↓
実行時の総メモリエンベロープ(重み + KVキャッシュ + 作業領域)の把握
↓
それを受け止められるハードウェアクラスの選定
決して「重みが19GBだから20GBあれば足りる」とは判断しません。
参考: 27B級のローカルモデルはどのくらい賢いのか?
「自分のPCで動かすモデルなんて、ChatGPTに比べたらオモチャ同然なのでは?」と感じる人もいるかもしれません。 参考として、Qwenが公表しているQwen3.8-27Bのモデルカードに記載された、フロンティア級モデル(Opus4.6 Max)との比較値を見てみましょう。
| ベンチマーク指標 | Qwen3.8-27B | Opus4.6 Max | 指標が測っている内容 |
|---|---|---|---|
| GPQA Diamond | 89.2 | 91.3 | 専門知識・高度な科学的推論能力 |
| Terminal Bench 2.1 | 73.0 | 78.2 | ターミナル操作や自律的なコマンド実行 |
| SWE-bench Pro | 61.7 | 53.4 | 実際のソフトウェア開発課題の解決能力 |
| LiveCodeBench v6 | 90.3 | 88.8 | 汚染のない最新問題に対するコーディング力 |
※Qwen公表のモデルカード記載値。測定条件は各社・各行で異なり、独立した公平な第三者ランキングではありません。また製品全体の総合的な優劣を示すものではありません。
これを見ると、高度な推論ではクラウド最上位に一歩譲るものの、プログラミングやコーディングの特定のテストでは肩を並べる、あるいは上回るスコアを出しています。 もちろん、これだけで「ローカルがクラウドに勝った」とは言えません。ツール連携のスムーズさや、長時間の安定性、多言語の自然さなど、完成されたクラウドサービスが持つ総合力は依然として強力です。 しかし、少なくとも「ローカルAIは小さくて実用にならない」という認識は過去のものになりつつあります。
巨大open-weightは普通のPCに収まらない: DeepSeek-V4.1-Flash
「量子化すれば27Bでも動くなら、もっと大きな最先端オープンモデルも全部自宅で動かせるのでは?」
そう考えるかもしれませんが、さらに上を見ると、まったく別の壁が現れます。
中国のDeepSeekが2026年9月10日に公開したDeepSeek-V4.1-Flashを見てみましょう。このモデルは552Bパラメータ(約5,520億個)という、桁違いの規模を持つMoE(Mixture-of-Experts)モデルです。
deepseek-ai/DeepSeek-V4.1-Flash · Hugging Face
We’re on a journey to advance and democratize artificial intelligence through open source and open science.
huggingface.co

MoEとは、巨大なネットワーク全体を一度にすべて動かすのではなく、入力された内容に応じて必要な専門家(エキスパート)部分だけを選んで計算する仕組みです。DeepSeekの公式発表によると、V4.1-Flashが1回の入力処理で実際に計算に使う(activeにする)パラメータ数は約8B、出力生成時でも約16Bしかありません。
ここで、「計算に使うのが16Bだけなら、16Bが収まる24GBや32GBのパソコンで動くのではないか?」と考えられるのですが、ここが落とし穴です。
計算の瞬間にアクティブになるパラメータ数と、メモリ上に保持しておかなければならないモデル全体の重みは別物です。
推論時にアクティブになるパラメータ(16B)
≠
常時メモリに載せておくべきモデル全体の重み(552B分)
どの単語が来たときにどのエキスパートが呼ばれるかは事前には分からないため、モデル全体の重みをすべて高速なメモリ上に待機させておく必要があります。
実際、大規模言語モデルの高速推論エンジンであるvLLMが公開したDeepSeek-V4.1-Flashの公式デプロイレシピを確認すると、次のような仕様になっています。
- モデル全体のチェックポイントサイズ: 約511GB
- vLLMレシピのメモリ見積もり(vram_minimum_gb):614GB
この614GBは、約511GBの公開チェックポイントにvLLMレシピのスキーマ上の1.2倍のヘッドルームを加えた標準構成の見積もりです。「どんな実装でも物理的に614GBのVRAMが絶対必要」という意味ではありません。
DeepSeek-V4.1-Flashほど巨大になると、24GBや32GBの一般的なGPU 1枚へモデル全体を載せるのは難しくなります。
ただし、これは「個人ではローカル実行できない」という意味ではありません。

NVIDIA DGX Spark
128GB統合メモリを備えたデスクトップAIワークステーション
一般的なGPUのVRAM容量では扱いにくい巨大モデルを、個人や小規模な開発環境まで持ってくるためのAIワークステーション。GB10 Grace Blackwell Superchipと128GBの統合メモリを、小型筐体に収めています。
| 項目 | 内容 |
|---|---|
| AIチップ | NVIDIA GB10 Grace Blackwell Superchip |
| AI演算性能 | 最大1 PFLOP(FP4・sparsity使用時) |
| 統合メモリ | 128GB LPDDR5x |
| メモリ帯域 | 273GB/s |
| 高速接続 | ConnectX-7 / 200Gbps |
| 対応モデル規模 | 単体で最大200B、2台構成で最大405B(NVIDIA公称) |
現在は、NVIDIA DGX Sparkのように128GBの大容量統合メモリを持つ小型AIワークステーションが登場しています。DGX SparkはCPUとGPUが同じ128GBのメモリ空間を共有するため、一般的なGPUのVRAM容量だけで考える必要がありません。
2台を高速接続すれば、合計256GBの統合メモリを持つマルチノード構成にできます。ただし、それだけでDeepSeek-V4.1-Flashが収まるわけではありません。公開されている実動例では、量子化したweightsを使ったり、巨大なEngramテーブルをNVMeへ置いたりすることで、3台や4台のDGX Spark上でDeepSeek-V4.1-Flashを動かしています。
普通のGPU 1枚
→ 収まらない

大容量統合メモリ機
→ より大きなモデルを扱える

複数のDGX Spark + 量子化 / NVMeオフロード
→ 数百B級モデルも現実的な検討対象になるそのため、open-weightだから普通のPCで動くわけではないが、大規模サーバーが必須とも限らないというのが現在の実態に近いです。
その分1個100万円を超えてくる価格帯なのですが、割と個人法人問わず持っている人は多いです。実際、数百万円でこれからリリースされる強いモデルを乗り換えながら、自分専用に自由に無限に動かす事が出来、ハードウェア自体もある程度のリセールも期待できるので投資としてはそこまで悪くないと思います。
ただし、DGX SparkがすべてのAI用途で最善というわけではありません。メモリ帯域は273GB/sで、RTX 5090の1,792GB/sと比べると約6分の1です。メモリ帯域は載ったモデルを動かすスピードに大きく関わってきます。
そのため、24〜32GB以内に十分収まりやすい画像生成などの用途では、RTX 5090のような一般向けハイエンドGPUの方が適している場合があります。
Scaleを3段階で見る
改めて、3段階のスケールを同じ基準で並べて比較してみましょう。
モデル規模と必要ハードウェアクラスの3段階
| モデル | モデルの重み・チェックポイント | 実行時メモリエンベロープ(目安) | 該当するハードウェアクラス |
|---|---|---|---|
| Gemma 3 12B(Q4) | 約7.3GB(GGUFファイル) | 重み(7.3GB)+ KVキャッシュ・作業領域が必要 | 一般向けPC(Consumer local) / 12〜16GBメモリ、RTX 5060 Ti 16GB / RTX 5070 Ti 16GBなど |
| Qwen3.8-27B(Q4) | 約19GB(GGUFファイル) | 条件付き24GB級での動作例あり。32GB級なら長文脈も余裕を確保 | ハイエンドPC(High-end local) / 24〜32GB VRAM GPUや大容量Mac、RTX 5090など |
| DeepSeek-V4.1-Flash | 約511GB(公式チェックポイント) | 標準vLLMレシピは614GBを見積もる。量子化・NVMeオフロードを使った複数DGX Sparkでの実動例あり | 大容量統合メモリ / マルチノードLocal〜Server-class / DGX Spark複数台、H200、GB200等 |
重みサイズはGGUFまたは公式チェックポイントの基準値。必要メモリは文脈長や並列度、量子化、オフロード方法などの実行条件により変動します。固定の最小値を断定するものではありません。
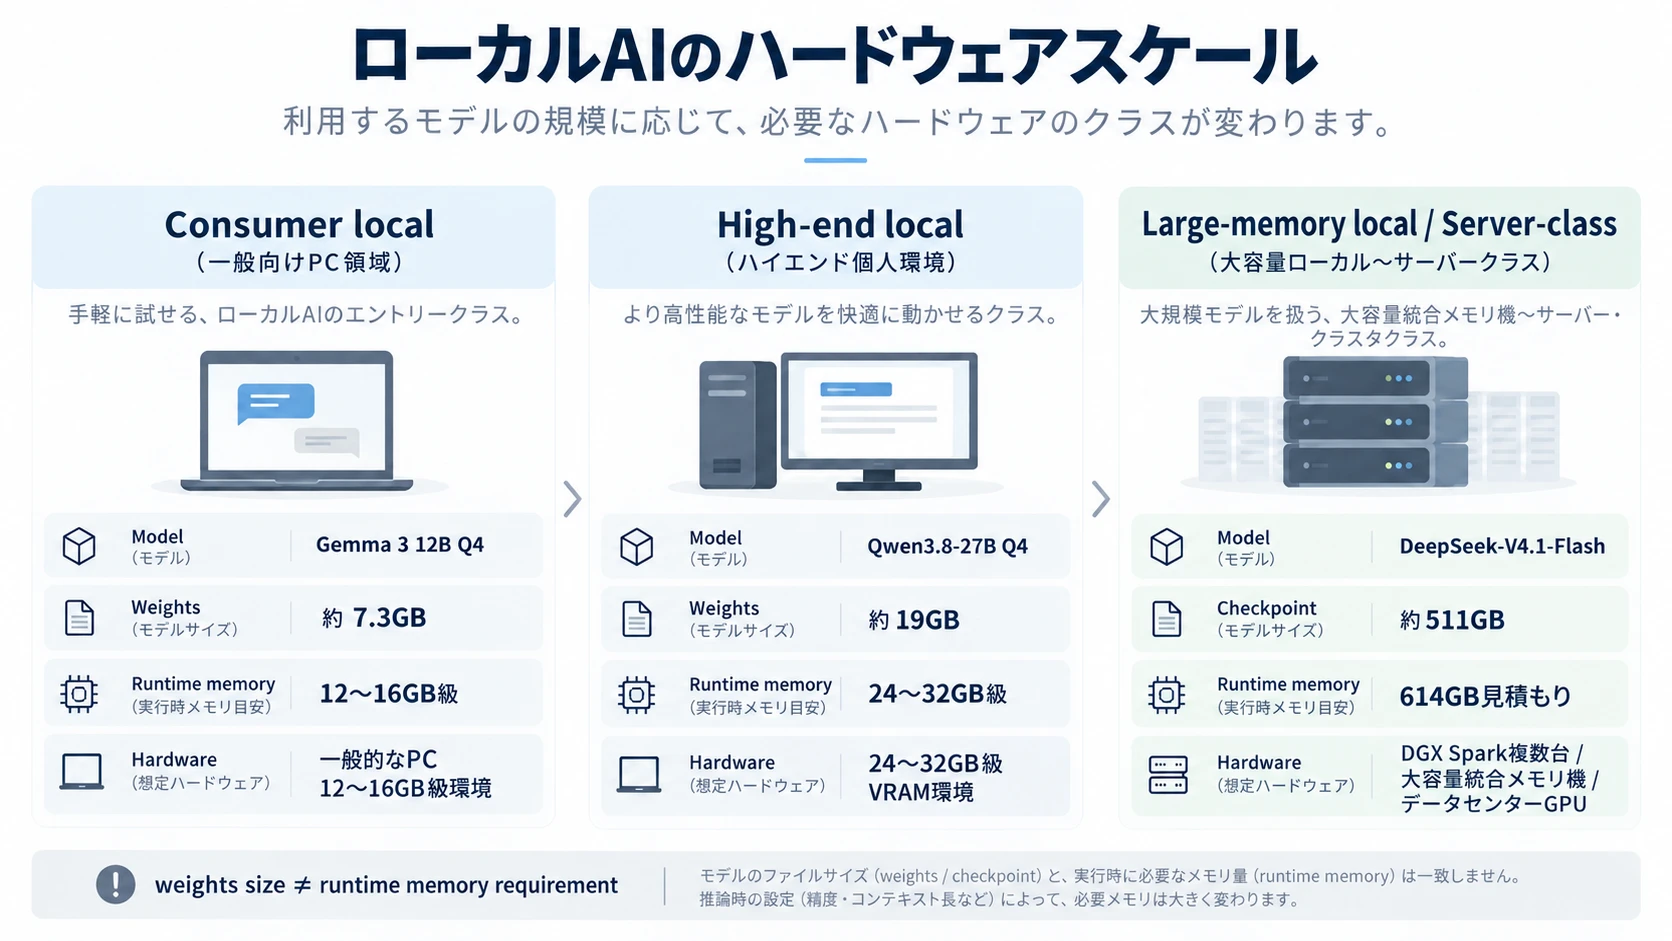
ここで絶対に混同してはならないのは、重みのファイルサイズと、実際に動かすときに必要なメモリは一致しないということです。重みファイルはあくまで静止したデータであり、実際に動かすには文脈の長さやRuntimeに応じた追加のメモリ領域が必ず求められます。
Cloud GPUは何のためにある?
ここまで読むと、一つの現実的な壁に突き当たります。
「27Bやそれ以上のオープンモデルを試したいけれど、そのために数十万円〜数百万円もするGPUやパソコンを買うのはハードルが高い。」
そこで登場するのが、冒頭のOwnership mapで触れたクラウドGPUです。
クラウドGPUとは、「動かすモデルやソフト(Runtime)は自分で管理したいが、巨大なGPUハードウェアだけは買わずに時間単位で借りたい」という要望に応える中間的な解決策です。
ローカルAI:
自分のモデル + 自分のRuntime + 自宅に買ったGPU

クラウドGPU:
自分のモデル + 自分のRuntime + ネット越しに借りたGPU
ローカルAIとクラウドGPUでは、動かすソフトウェアの仕組み自体はほとんど同じです。どちらもOllama、vLLM、llama.cpp、あるいは画像生成のComfyUIなどを動かします。唯一違うのは、「そのGPUが自分の机の下にあるか、データセンターにあるか」だけです。
クラウドGPUを使えば、たとえばRTX 4090や5090クラスのGPUを1時間あたり数十円〜百数十円程度で借りて、その間に大量に好きな画像を生成したりできます。さらに、個人では買いずらい80GB VRAMのサーバー用GPUであるA100やH100(1時間100~300円)を借りて、巨大モデルを動かしてみることも可能です。使っている間だけしか課金されないので、柔軟に利用する事ができます。
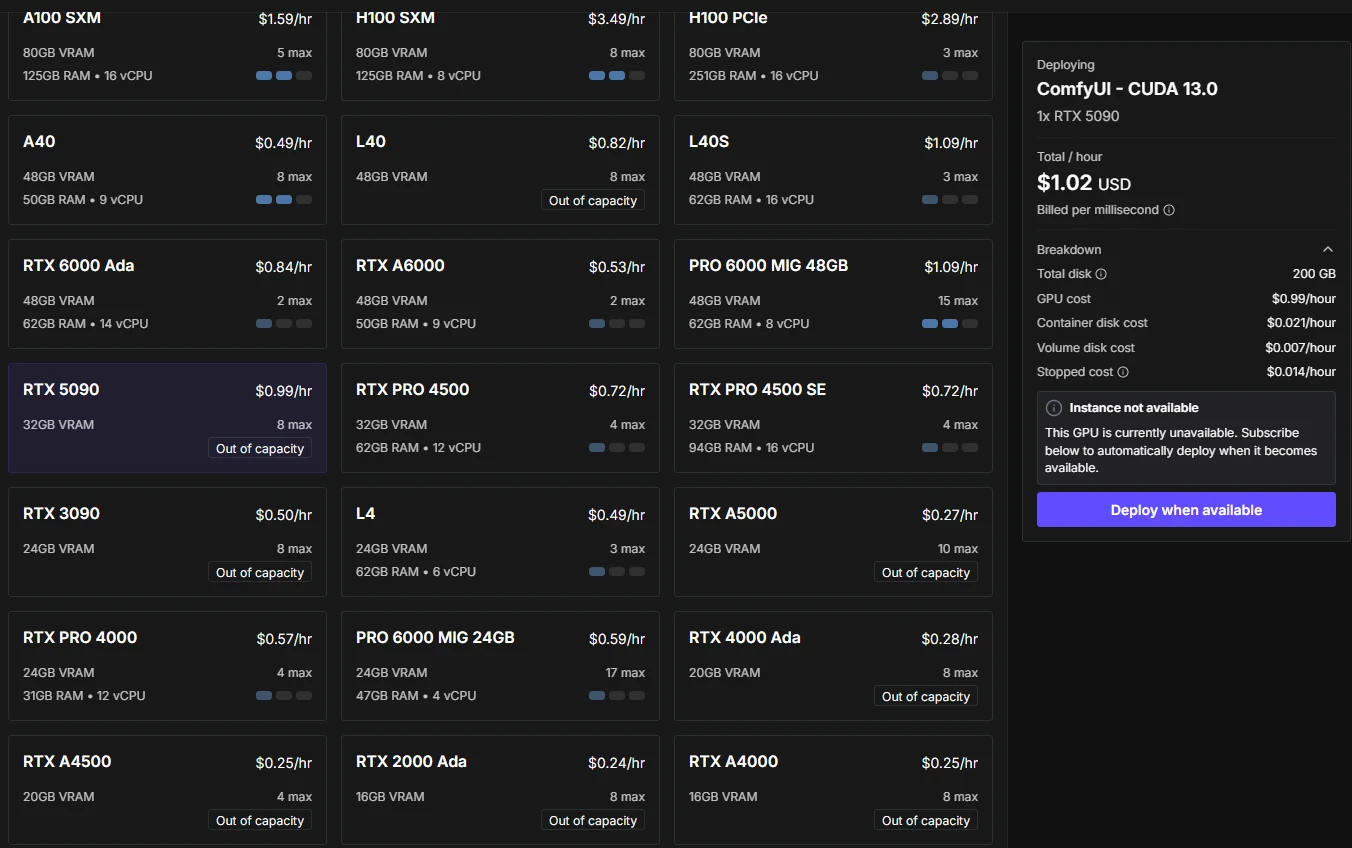
これはrunpodというサービスです。かなりお手軽に始める事が可能です。
ハードウェア性能や価格性能比が年々向上している中でも、クラウドGPUは初期費用なしで高性能GPUを使えるため、依然としてコストパフォーマンスに優れています。その一方で、人気の高いGPUは利用率も高く、タイミングによっては空きが出るまで待つことがあります。
また、データを残す場合はストレージ料金がかかり、サービスによっては通信量に応じた料金も発生します。そのため、GPUの利用料金だけでなく、保存データや通信コストも含めて管理することが重要です。(GPU料金と比べるとそこまで高くない)
それでも、「高額なハードウェアを買い切るか」「完成品のChatGPTで妥協するか」の間に、「ハードウェアの所有権だけを事業者に預ける」という選択肢があることを知っておくと、AIの活用の幅は一気に広がります。
クラウドGPUおすすめ比較【2026年】料金・使いやすさ・用途別に選ぶ
クラウドGPUで何を借りるのか、どのGPUが必要なのか、料金のどこを見るべきかを整理し、RunPod・Vast.ai・Lambdaなどから用途別に候補を絞ります。
ちまとめ
何が変わる? 6軸だけ比較する
AIの仕組みと責任の所在が整理できたところで、実際にどの形態を選ぶかを決めるための6つの評価軸を整理します。単なる「どっちがお得か」ではなく、以下の軸で自分の目的に照らし合わせましょう。
1. 性能の上限(Capability ceiling)
- 完成AIサービス: 事業者が抱える数万台規模のスーパーコンピュータと最新のフロンティアモデル、Web検索や画像認識などの複合システムをそのまま利用できます。純粋な知能の上限は最も高いです。
- ローカルAI: 自分の手元にあるPCのスペックがそのまま性能の絶対的な上限(天井)になります。
- クラウドGPU: 借りるGPUの数を増やせば、個人のPCスペックをはるかに超えた上限まで引き上げられます。
2. データの経路とプライバシー(Data path / Privacy)
- ローカルAI: ネットワーク通信を遮断したローカルRuntimeを使えば、入力した文章や読み込ませた機密ファイルが外部のサーバーへ送信されることは物理的にありません。
- 完成AIサービス / API: インターネット経由でデータを送信します。ただし「クラウドだから一律危険」ではありません。商用APIでは「入力データを学習に利用しない」と明記されている規約が一般的ですが、会話内容は普通に見られています。逆にローカルであっても、拡張機能やログ送信、Web検索連携が有効になっていれば通信は発生します。「ローカルだから絶対安全」「クラウドだから危険」ではなく、実際のデータの流れと利用規約で判断しましょう。
3. オフライン動作(Offline)
- ローカルAI: モデルデータとRuntimeが一度手元に揃えば、電波の届かない環境でも完全に単体で動作します。
- 完成AIサービス / API / クラウドGPU: いずれもインターネット接続が必須です。
4. 自由度とカスタマイズ(Freedom / Customization)
- ローカルAI / クラウドGPU: どのモデルを使うか、どの量子化方式にするか、システムプロンプトや温度パラメータをどう設定するか、どんなツールと連携させるかを100%自分でコントロールできます。規制の緩いモデルを選んで成人向けAIを動かすことも可能です。ここに大きなメリットを見いだす人が多いと思います。
- 完成AIサービス: サービス全体の使い勝手は極めて高いですが、モデル自体の挙動や安全性フィルター、機能の追加・削除はすべて事業者のアップデート次第になります。
5. セットアップと保守の手間(Setup & Maintenance)
- 完成AIサービス: アカウントを作るだけで即座に使えます。メンテナンスはゼロです。
- API: 多少のプログラミング知識は必要ですが、サーバー自体の保守は不要です。
- クラウドGPU / ローカルAI: GPUドライバのインストール、CUDAの設定、Runtimeの更新、ストレージの空き容量管理など、すべて自分でトラブルシューティングを行う知識が求められます。
6. コストの構造(Cost shape)
4つの形態では、お金の出方が根本的に異なります。
完成AIサービス: 月額課金(サブスクリプション)中心(例: 月額20ドル)
API: 従量課金中心(使ったトークン数に応じて支払い)
クラウドGPU: 時間課金 + ストレージ保持費 + 通信費
ローカルAI: ハードウェアの初期購入費用 + 日々の電気代
「何ヶ月使えばローカルAIは元が取れるか」という単純計算はあまり意味を持ちません。なぜなら、月額20ドルで使えるChatGPTの裏側で動いているハードウェアは数百万円〜数千万円規模のものです。
また、フロンティアモデルはオープンウェイトではないので、最先端AIを使いたいなら月額課金必須となります。
結局どこから始める?
選び方
用途と『自分で持ちたい責任』に合わせて選ぶ
1. 最も賢いAIを手間なく使いたい、環境構築に時間をかけたくない
→ 完成AIサービス(ChatGPT、Claudeなど)
最初からPCを買い換える必要はありません。最新のフロンティアモデルと周辺機能をそのまま使うのが最も生産的です。
2. 自分のWebアプリや自動化プログラムにAIを組み込みたい
→ API利用(OpenAI APIなど)
サーバー管理やGPUの故障対応を背負うことなく、従量課金で確実な推論能力を手に入れられます。
3. オープンモデルを自由に試したいが、高価なGPUを買う決心はつかない
→ クラウドGPU(RunPodなど)
数時間だけ24GB〜80GBのGPUを数十円〜数百円で借り、自分の手でモデルを動かす感覚を体験するのが最もリスクの低い検証方法です。
4. 社内機密や個人情報を外部に一切送信したくない、オフラインで動かしたい
→ ローカルAI(Ollama + 12B級モデル)
手元のPCで完結するローカル実行が第一候補になります。
5. 日常の作業ごとに要件が異なる
→ ハイブリッド運用(Cloud + Local)
日常の高度なリサーチやプログラミング相談はクラウドの完成サービスに頼り、機密データの要約や定型バッチ処理は手元のローカルAIに任せるという使い分けが、現在最も現実的で賢いアプローチです。
どの選択肢でも、完成AIサービスの契約は必須だと思います。ローカルAIを使うにしても、AIに聞きながら進めた方が圧倒的に効率が良いです。
もしローカルAIに興味を持ったとしても、最初から高価なグラフィックボードを買いに走る必要はありません。
まずは今使っているパソコンにOllama,llama.cppなどの無料ソフトをインストールし、Gemma 3 12Bなどの扱いやすいQ4量子化モデルを1つ動かしてみてください。分からないところがあれば、クラウドAIに聞きましょう。
手元のPCで文字が少しずつ生成される様子を見れば、AIが自分のマシン上で計算されている実感とともに、生成速度、メモリの減り方、そしてファンの回転音など、カタログスペックだけでは分からない「ローカルAIの実態」が理解できるはずです。
確認した一次情報・公式ドキュメント
- Google — Gemma 3 12B model card
- ggml-org — Gemma 3 12B GGUF
- Qwen — Qwen3.8-27B model card
- ggml-org — Qwen3.8-27B GGUF
- DeepSeek — DeepSeek-V4.1-Flash release announcement
- DeepSeek — DeepSeek-V4.1-Flash model card
- vLLM Recipes — DeepSeek-V4.1-Flash deployment recipe
- NVIDIA — DGX Spark
- Mia’s AI Lab — DeepSeek-V4.1-Flash on 3×/4× DGX Spark
- Hardware Corner — Qwen3.8 27B hardware tests and VRAM benchmarks
- Ollama — Official Documentation
- llama.cpp — Official Repository