【2026年版】ローカルLLM向けハードウェア選定ガイド:動かしたいモデルから逆算するGPU・PCの選び方
Qwen3.8-27B・Flash-Next・GLM-5.3-Flashを動かす現実的なメモリ構成と導入ルート
最終更新 2026.09.17
目次24項目開く
ローカルLLMの導入を検討するとき、誰もが最初に直面するのが**「結局どのGPUやPCを買えばいいのか」**という問題です。
かつては「VRAMが一番大きいGeForceを買えばいい」というシンプルな話でした。しかし、モデルアーキテクチャの多様化とメモリ技術の進展が進んだ現在、その前提は崩れつつあります。
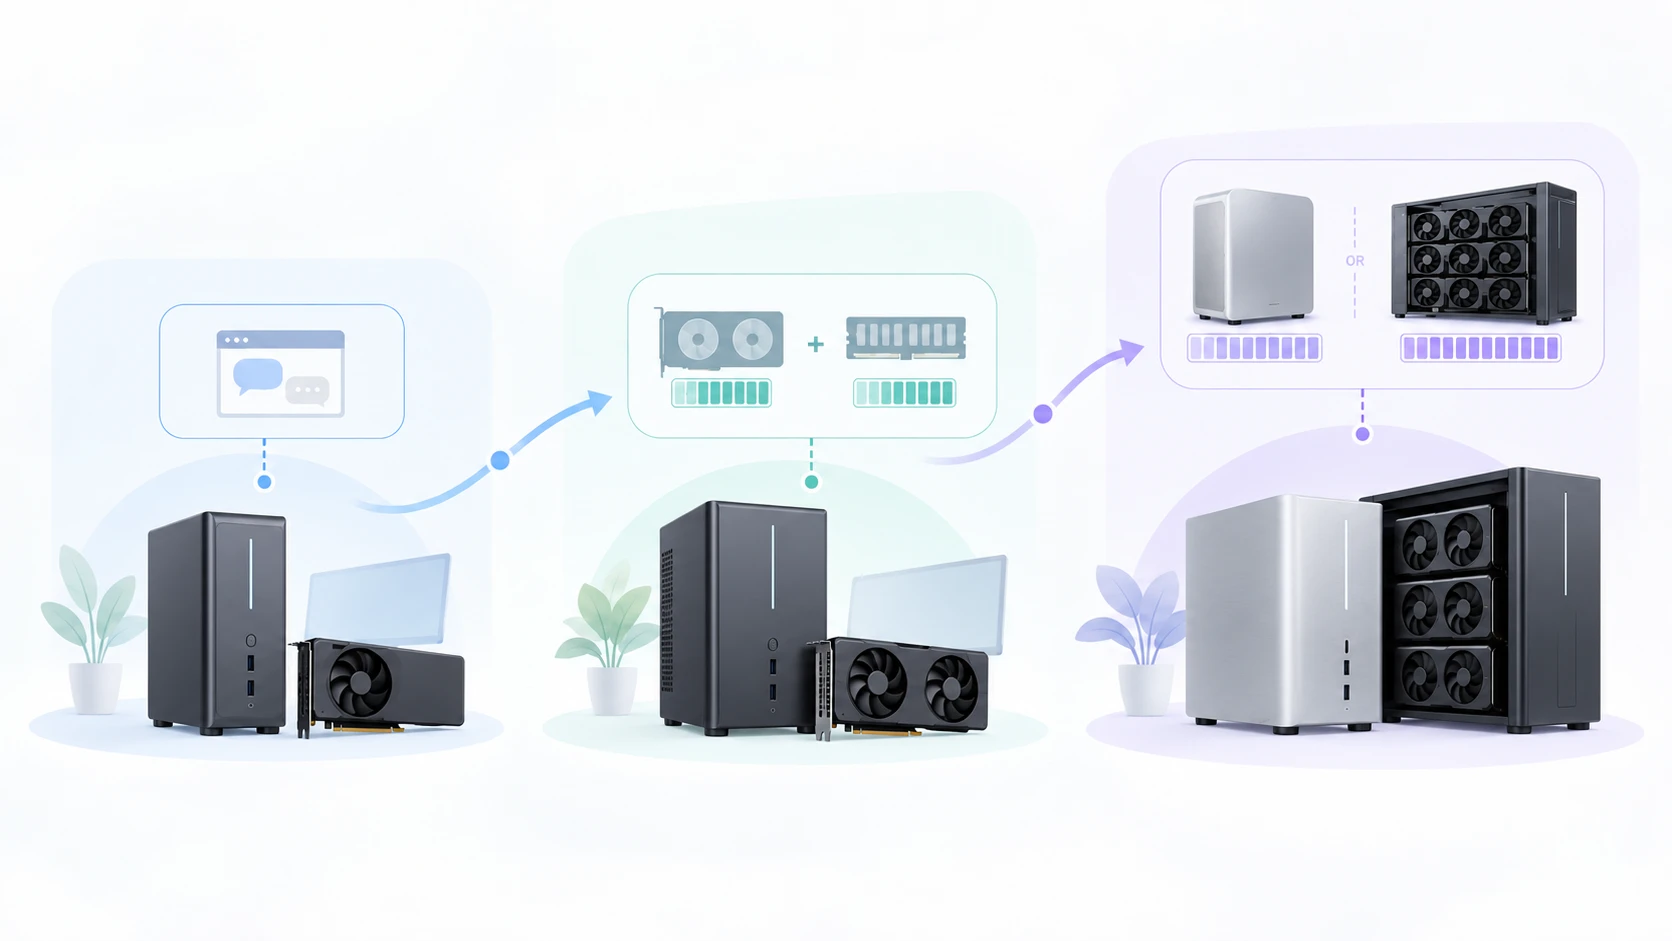
単一GPUにすべて収める構成、GPUとシステムRAMを併用するオフロード構成、128〜256GB級のユニファイドメモリ(統合メモリ)を活用する構成など、選ぶべきルートはモデルの性質によってまったく異なります。
本記事では、要求メモリと用途のキャラクターが明確に分かれる3つの代表的モデルを基準に、ベンチマーク性能、実測生成速度(tok/s)、国内相場、そして複数GPU運用の落とし穴まで踏み込んで整理します。
30秒でわかる要点:モデルが違えば、組むべきハードウェアも変わる
「どのGPUが一番速いか」ではなく、**「動かしたいモデルを、どこにどう配置して推論させるか」**から逆算するのが失敗しない鉄則です。
- Qwen3.8-27B(日常使い・コーディング基準)
- 推奨環境: 24〜32GBの単体GPU
- 中古RTX 3090、RX 7900 XTX、Intel Arc Pro B70など、GPU単体なら20万〜30万円台から現実的な選択肢があります。
- Qwen3.8-Flash-Next(高推論力・長文コンテキスト)
- 推奨環境: GPU+大容量システムRAM、または128GB統合メモリ
- モデルサイズは約90〜110GBですが、埋め込みテーブル(PLE)をホストRAM側に逃がせる構造のため、24〜32GB GPU+メインメモリ増設や、128GB統合メモリ完成機(Mac Studio / Strix Halo機)で実用速度が出せます。
- GLM-5.3-Flash(SWE特化・超大規模検証)
- 推奨環境: 256GB級のメモリ空間
- 4bit量子化でも約175〜196GBのメモリ使用が観測されています。192GBでも条件次第では動く余地がありますが、OS・KVキャッシュ・ランタイム用の余白が小さくなるため、継続運用まで考えるなら256GB級のメモリ空間を基準にした方が分かりやすいです。
1. 候補モデルの能力差と要求スペック
高額なハードウェアを揃えても、用途に対してモデルが過剰・不足であれば本末転倒です。まずは商用フロンティアモデルをリファレンスとして、3モデルの立ち位置を整理します。
主要ベンチマーク比較
| モデル | 種別 | DeepSWE v1.1 | GPQA Diamond | SWE-bench Pro |
|---|---|---|---|---|
| GPT-5.5 | クローズドモデル | 67.0 | 93.6 | 58.6〜59.4 |
| Claude Opus 4.7 | クローズドモデル | — | 94.2 | 64.3 |
| GLM-5.3-Flash | オープンウェイトモデル | 63.4 | — | — |
| Qwen3.8-Flash-Next | オープンウェイトモデル | 58.7 | 91.7 | 62.5 |
| Qwen3.8-27B | オープンウェイトモデル | 42.2 | 89.2 | 61.7 |
※各ベンダー公表値。評価条件が異なるため総合順位ではなく能力帯の目安です。
特定ベンチマークでは商用最上位に近いスコアも見られますが、日常会話のニュアンス、ツール呼び出しの安定性、日本語品質まで1つの数字で判断することはできません。
ここで重要なのは、能力だけでなくそのモデルをローカルで動かすために、どれだけのメモリが必要になるかです。3モデルはこの差が非常に大きいため、次に実用的な4bit級の量子化を基準として必要メモリを見ていきます。
4bit量子化時の実効メモリ消費量
| モデル | 主な4bit形式 | 実効メモリ占有量 | 代表的なハードウェアクラス |
|---|---|---|---|
| Qwen3.8-27B | Q4_K_M など | 約16〜19GB | 24〜32GB 単体GPU |
| Qwen3.8-Flash-Next | IQ4 / AWQ / NVFP4 / MLX | 全体約90〜110GB(PLEテーブル約28GBをRAM退避可) | 24〜32GB GPU+大容量RAM / 128GB統合メモリ / 2〜4GPU |
| GLM-5.3-Flash | W4A16 / MLX 4bit など | 重み約175〜178GB / ピーク約175〜196GB | 256GB統合メモリ / 256GB VRAM(マルチGPU) |
2. 実測速度(tok/s)と価格を評価する際の注意点
ハードウェアの比較表を見る前に、誤認しやすいポイントを整理しておきます。
DecodeとPrefillは別の速度
この先の表では、主にDecodeとPrefillという2種類の速度を使います。
- Prefill(Prompt Processing / pp):入力したプロンプトや参照文書をまとめて読み込む処理です。
pp512なら512 token、pp8192なら8192 tokenを処理したときの速度を表します。 - Decode:読み込みが終わった後、次のtokenを1つずつ生成していく処理です。チャットで「文章がどれくらいの速さで出てくるか」という体感には、こちらが強く効きます。
長い資料を毎回読み込ませるRAGや長文要約ではPrefillも重要ですが、普段の対話速度を見たいならまずDecodeを確認すると分かりやすいです。
同じVRAM容量でもDecode速度が違う理由
1ユーザー・batch 1のLLM Decodeは、特にDenseモデルではGPUの演算性能だけでなくメモリ帯域に制約されやすい処理です。ざっくり見るなら「実効メモリ帯域 ÷ 1 tokenを生成する際に読み出すweight量」で速度の上限感を掴めます。
そのため、VRAM容量が同じ24GBでも速度は同じになりません。大容量VRAMは「モデルが載るか」を決め、メモリ帯域は「載ったモデルをどれだけ速く読めるか」に大きく関わります。実際の速度には量子化方式、KV cache、カーネル効率、MoEの構造なども影響するため、この関係はあくまで目安です。
比較表を読むときの4つの注意
- 量子化形式やランタイムの違い 同じ「4bit」と表記されていても、Q4_K_M、IQ4、AWQ、NVFP4、MLX 4bitでは内部構造や演算負荷が異なります。本稿の数値は「その構成で実証された実績値」として参照してください。
- ベースライン速度と投機デコード(MTP/DFlash)の分離 MTPやDFlashなどでは、次のtoken候補を複数先まで予測し、まとめて検証することでDecodeを高速化します。そのため、同じGPUでも対応モデル・ランタイム・設定によってtok/sが大きく変わります。ハードウェア自体の差とソフトウェア最適化の効果を切り分けるため、本稿ではベースラインと最適化後を分けて見ます。
- マルチGPUの「隠れコスト」 GPUカードを複数枚挿す場合、カード代だけでなくマザーボードのPCIeスロット間隔、レーン数、1200〜2000W級の電源、冷却ファン、排熱対策、騒音が大きなハードルになります。4 GPU構成などは通常の自作PCの延長線上にはありません。
- 「10万円あたりのtok/s」はあくまで目安 GPU単体価格で計算した構成と、PC本体丸ごと(完成機)の価格が混在するため、コスパ指標はシステム全体の前提条件を加味して見る必要があります。
GPUを買う前に、使いたいソフトウェアも確認する
llama.cppを中心に使うなら、NVIDIAだけでなくRadeon、Intel Arc、Apple Siliconも現実的な選択肢です。一方で、最新モデル向けの高速kernel、特殊な量子化、TensorRT-LLM、研究コード、学習系ツールまで広く触りたい場合は、CUDA環境の方が対応範囲が広い傾向があります。
vLLMやSGLangにもCUDA以外の実行経路はありますが、「対応している」ことと「最新機能が同じタイミング・同じ条件で使える」ことは別です。価格やVRAM容量だけでGPUを選ばず、自分が使う予定のランタイムや周辺ツールがそのGPUで動くかを購入前に確認してください。
3. Qwen3.8-27B:24〜32GB 単一GPUの世界
Qwen3.8-27Bは4bit量子化(Q4_K_M)で約16〜19GBを使用します。コンテキスト長の確保を考慮すると、24GBまたは32GBのVRAMを持つ単体GPUで完結させるのが見やすい構成です。
ただし、weightがVRAMに収まることと、長いコンテキストをそのまま扱えることは別です。会話履歴やコード、参照文書が長くなるほど、過去tokenの情報を保持するKV cacheもメモリを消費します。24GB GPUに19GB前後のweightが載っても、残りすべてを自由にcontextへ使えるわけではありません。長文脈を重視する場合は、KV cacheの量子化設定や実際に使いたいcontext長まで含めて確認してください。
代表的構成の実測性能(Baseline)
| GPU / 構成 | VRAM | 量子化 / ランタイム | 条件 | 生成速度 (Decode) | 処理速度 (Prefill) |
|---|---|---|---|---|---|
| RTX 5090 | 32GB | Q4_K_M / llama.cpp CUDA | 投機なし | 65.1〜65.7 tok/s | 969.8〜3,496.8 tok/s |
| RTX 4090 | 24GB | Q4_K_M / llama.cpp CUDA | MTPなし | 45.20 tok/s | 2,855.69 tok/s |
| RTX 3090 | 24GB | Q4_K_M / llama.cpp CUDA | 投機なし | 41.53 tok/s | 約1,399 tok/s |
| RX 7900 XTX | 24GB | Q4_K_M / llama.cpp Vulkan | MTPなし | 35.8〜36.0 tok/s | 192.0〜230.5 tok/s |
| Arc Pro B70 | 32GB | Q4_K_M / llama.cpp SYCL | MTPなし | 27.5〜33.3 tok/s | 426〜1,164 tok/s |
| Radeon AI PRO R9700 | 32GB | UD-Q4_K_XL / llama.cpp Vulkan | MTPなし | 29.46 tok/s | 629.8〜680.5 tok/s |
| 2x RTX 5060 Ti | 16GB×2 | Q4_K_M / llama.cpp CUDA | 2GPU / 投機なし | 38.3 tok/s | —(MTP時 約76) |
| Arc Pro B60 | 24GB | UD-Q4_K_S / llama.cpp SYCL | MTPなし | 13.26 tok/s | 459.73 tok/s |
実測から明らかなように、「VRAMに載ること」と「速いこと」は同義ではありません。メモリ帯域幅がボトルネックになるため、Arc Pro B60のように容量は24GBあっても13 tok/s台にとどまる例があります。
旧世代ながら約936GB/sの帯域幅を持つRTX 3090が41.5 tok/sを維持している点は注目に値します。
国内相場とコストパフォーマンス
| 選択肢 | 国内相場(概算) | 生成速度 (Base) | 10万円あたりtok/s | 特徴と評価 |
|---|---|---|---|---|
| Tesla V100 32GB PCIe (中古) | 約11〜13万円 | 約35〜36 | 約27〜33 | |
| RTX 3090 24GB (中古) | 約22〜24万円 | 41.53 | 約17〜19 | 抜群のコスパ。中古の状態・保証の見極めが必須 |
| RX 7900 XTX 24GB | 約26〜27万円 | 35.8 | 約13.4 | 新品24GBの堅実な選択肢。ROCm/Vulkan環境の確認を推奨 |
| Arc Pro B70 32GB | 約22〜27万円 | 33.3 | 約12〜15 | 20万円台で32GBを確保可能。CUDA前提ツールとの互換性に留意 |
| 2x RTX 5060 Ti 16GB | 約26〜32万円 | 38.3 | 約12.0〜14.7 | 既存カード流用向け。2枚挿し対応PC環境が必要 |
| Radeon AI PRO R9700 32GB | 約30〜35万円 | 29.46 | 約8.4〜9.8 | ワークステーション向けの安定志向 |
| Arc Pro B60 24GB | 約18〜20万円 | 13.26 | 約6.6〜7.4 | 安価に載るが、生成速度は明確に遅い |
| RTX 5090 32GB | 約84〜95万円 | 65.66 | 約6.9〜7.8 | 単体最速かつ32GB。性能は最高峰だが価格も極めて高い |
| RTX 4090 24GB (新品) | 約69〜100万円 | 45.20 | 約4.5〜6.6 | 現在の新品実売価格は割高。既存所有者以外には推奨しづらい |
※2026年9月中旬時点の相場(PC本体を含まないGPU単体価格中心)。
中古勢が強すぎますね。耐久性、リセールを考慮すると、正直判断はできないです。
なお、投機的デコード(MTP等)を適用することで、RTX 3090が約63.5 tok/s、RTX 5090が100〜180 tok/s前後にまで引き上げられる事例も報告されています。
4. Qwen3.8-Flash-Next:GPU+システムRAMの協調が活きる世界
Flash-Nextのモデルファイル全体は約90〜110GBに達します。一見すると100GB級のVRAMが必須に見えますが、本モデル特有の構造により、異なるアプローチが可能です。
PLE(埋め込みテーブル)のホストRAM退避
Flash-Nextにはper_layer_token_embd.weightという巨大なPLE / n-gramルックアップテーブルが存在し、全体の約27〜29GBを占有しています。
このテーブルは通常の線形代数演算(行列積)を行う層ではなく、トークン列に応じて特定の行を参照(Lookup)する役割を持ちます。そのため、llama.cpp等では**「モデル幹・アテンション・KVキャッシュはGPU VRAMに置き、PLEテーブルはホストRAM(メインメモリ)に置く」**という分離配置が実用化されています。
この仕組みにより、24〜32GBのコンシューマー向けGPUに十分なメインメモリを組み合わせることで、実用速度を狙えます。
ただし、Host RAMへ逃がせるからといってPC側の構成が何でも同じになるわけではありません。GPUとCPU側メモリのやり取りやprefetchが入るため、CPU側のメモリ帯域、PCIeの世代・レーン数、GPUを挿しているslot、ランタイム側の実装も性能に影響します。特に複数GPUを組む場合は、物理的に挿せるかだけでなく、各slotが実際に何laneで動作するかまで確認した方が安全です。
VRAM割り当て量と速度推移(RTX PRO 6000環境)
| VRAM割り当て | 短文生成 (Short Decode) | 長文生成 (Long Context) |
|---|---|---|
| CPU Only | 約8.3〜8.5 tok/s | — |
| 8GiB | 35.7 tok/s | — |
| 16GiB | 37.9 tok/s | 20.6 tok/s (@123K) |
| 24GiB | 39.0 tok/s | 14.9 tok/s (@245K) |
| 32GiB | 42.2 tok/s | 15.4 tok/s (@245K) |
| 48GiB | 51.7 tok/s | 17.0 tok/s (@245K) |
| 96GiB | 109.1 tok/s | 21.6 tok/s (@245K) |
※UD-IQ4_XS / llama.cpp、ホストRAM約91GiB併用。48GiB以降はload modeも変わるため、32→48→96GiBの速度差をVRAM容量だけの効果とは扱えません。
24〜32GBのGPUでも、ホストRAMを適切に併用すれば約40 tok/s前後で動作します。一般的な自作PC環境でも、RTX 4090 (24GB)+64GBシステムRAMの構成で34.4〜34.7 tok/sの実効速度が確認されています。
このほか、4x RTX 3090で262K contextを完走した例や、RTX 5090 32GB+128GB RAMで動作させた例もあります。同じFlash-Nextでも量子化形式とランタイムが異なるため、速度の直接比較には使わず、成立する構成例として扱います。
主要構成ルートの比較
| 構成ルート | 概算価格ベース | 生成速度 (Decode) | コスト効率 (tok/s / 10万) | 評価・運用時の注意点 |
|---|---|---|---|---|
| 4x Tesla V100 32GB SXM2 | GPU約44〜64万円(基盤別) | 127(MTP時 156.6) | 約19.8〜28.9 | 数字上のコスパは高いが、SXM2専用サーバー基盤・爆音排熱対策が必須 |
| 2x RTX 3090 24GB + 64GB RAM | GPU約44〜48万円 | 約38〜40 | 約7.9〜9.1 | 一般的な自作PCで実現できる現実的なデュアルGPU構成 |
| MINISFORUM MS-S1 MAX 128GB | 完成機 約45万円 | 20.8(MTP時 33〜36) | 約4.6(MTP時 7.3〜7.9) | Strix Halo(Ryzen AI Max+ 395)搭載。省電力かつ小型の一箱完結機 |
| DGX Spark 128GB | 完成機 約114万円 | 43.3〜43.8 | 約4.8〜4.9 | Grace Blackwell (GB10) 搭載。CUDA環境がそのまま動く小型アプライアンス |
| RTX 4090 24GB + 64GB RAM | GPU約69〜100万円 | 34.4〜34.7 | 約3.4〜5.0 | 既存のハイエンドゲーミングPCを流用するなら有力 |
| Mac Studio M4 Max 128GB | 整備済等 約77万円 | 23.1 | 約3.0 | 静音・低消費電力。macOS/MLXエコシステム向け |
| RTX PRO 6000 96GB + RAM | 通常版 約300万円〜 | 109.1(SGLang時 199〜242) | 約4.4〜6.0 | 単体GPUで最高速度を狙うエンタープライズ構成 |
5. GLM-5.3-Flash:256GB級メモリを考える世界
GLM-5.3-FlashはDeepSWE v1.1で63.4を記録しており、ソフトウェア開発系ベンチマークで高い値が報告されています。
しかし、4bit量子化(W4A16 / MLX)でも重みは約175〜178GBあり、実測ピークメモリ使用量は約175〜196GBに達します。192GBでも条件次第では動く余地がありますが、OS・KVキャッシュ・ランタイム用の余白は小さくなります。継続運用を考えるなら256GB級を基準にする方が現実的です。
代表的構成の実測値
| 構成ルート | 現在の価格目安 | 価格の基準 | メモリ / 構成 | 実効速度 (Base) | 最適化後 / 長文時 | 特徴 |
|---|---|---|---|---|---|---|
| Mac Studio M3 Ultra 256GB | 約143.6万円 | Apple整備済・完成機 | 256GB 統合メモリ | 27.8 tok/s (@8K) | — | ピーク195.6GB消費。一箱で安定動作する基準機 |
| Mac Studio M3 Ultra 512GB | 約264.5万円 | Apple整備済・完成機 | 512GB 統合メモリ | 27.7 tok/s (@1K) | 21.8 tok/s (@64K) | 64Kコンテキストでも安定稼働する最上位構成 |
| 2x DGX Spark 128GB | 約228万円 | 約114万円 × 2台 | 計256GB 統合メモリ | — | 31.8〜81.1 tok/s | SGLang / DFlash2環境。CUDAスタックを維持可能 |
| 4x CMP 170HX 64GB | 約119万円〜 | 中国中古中央値 約29.7万円 × 4、カードのみ | 計256GB HBM | 41.95 tok/s | 67.91 tok/s (MTP) | カード単価は安いが、冷却・マイニング基盤構築が難所 |
| 4x RTX PRO 6000 96GB | 約618万円〜 | 米国中古中央値 約154.5万円 × 4、GPUモジュールのみ | 計384GB VRAM | 102.67 tok/s | — | 企業向けハイエンド。極めて高額(数百万円規模) |
| 4x A100 SXM4 80GB | 約1,080〜1,200万円 | 国内実売 約270〜300万円 × 4、GPUのみ | 計320GB HBM | 52.9 tok/s | 約80〜83 tok/s (MTP) | データセンター用リファレンス |
ハードウェア導入の現実解
このクラスになると、コンシューマー向けデスクトップPCを自作するアプローチはコスパ悪くなります。
- Mac Studio 256GB構成マルチGPU環境を自作せず、一箱で256GBの統合メモリを確保できるルートです。※なお、M5 Ultra搭載Mac Studioは2026年9月22日発売予定です。ベースモデルは96GB・949,800円からで、256GBは上位構成のカスタムオプションです。2026年9月17日時点では、M5 Ultra 256GBでGLM-5.3-Flashを同条件測定した実測値はありません。
- 2x DGX Spark(CUDA環境の維持)NVIDIA環境(vLLMやSGLang)のソフトウェアエコシステムをそのまま維持したい場合、小型ノード2台のインターコネクト構成が有力な選択肢になります。
- 中古マイニングカードやマルチGPUサーバーCMP 170HXなどのアクセラレータは部品代こそ抑えられますが、サーバー用ファンによる激しい騒音、専用電源、排熱処理、カスタムドライバの保守など、ハードウェア運用そのものに多くのリソースを割く必要があります。
6. 3大モデルの横断比較
| 比較軸 | Qwen3.8-27B | Qwen3.8-Flash-Next | GLM-5.3-Flash |
|---|---|---|---|
| 主な用途 | 日常アシスタント、軽量コーディング | 高度な推論、長文要約、自律エージェント | 本格的なSWE、大規模リファクタリング |
| 必要メモリ規模 | 24〜32GB | 約90〜110GB(PLE退避を活用可能) | 256GB以上(実効175〜196GB) |
| 代表的な構成 | 単一GPU(RTX 3090 / 5090など) | 24〜32GB GPU+大容量RAM / 128GB統合メモリ機 | 256GB統合メモリ(Mac Studio) / マルチGPU |
| 予算目安 | 約20万〜35万円(GPU単体) | 約45万〜90万円(システム全体) | 約120万〜200万円以上 |
| ハード構築の難易度 | 低(通常のデスクトップPCで可) | 低〜中(メモリ増設または小型完成機) | 高(一箱完結の統合メモリ機なら低〜中) |
7. 結論:何から始めるべきか
ステップ別の導入指針
1.まず日常的にローカルLLMを触ってみたい
- 推奨モデル:Qwen3.8-27B
- 選定基準:24〜32GBの単体GPU
- コスパ重視・中古許容:RTX 3090 / Tesla V100
2.長文コンテキストや高い推論能力を常用したい
- 推奨モデル:Qwen3.8-Flash-Next
- 選定基準:24GB以上のGPU + 64〜128GBシステムRAM
- 自作やメンテを省きたい:MINISFORUM MS-S1 MAX / Mac Studio M4 Max / DGX Spark
3.大規模なソフトウェアエンジニアリング用途で使いたい
- 推奨モデル:GLM-5.3-Flash
- 選定基準:256GB以上のメモリ空間 Mac Studio M3/M5 Ultra 256GB、またはDGX Spark 2台構成
- たまに試す程度なら、数百万円の機材を買う前にクラウドGPUを使うのもおすすめ
失敗しないための最終チェック
最初から最大のハードウェアを組む必要はありません。ローカルLLMの運用は、まず24〜32GBの単体GPUで27B級モデルを実務に組み込み、自身のボトルネックが「速度」なのか「メモリ(文脈長)」なのかを見極めてから次のステップ(128GB/256GB環境)へ進むのが、最も無駄のないアプローチです。
**「動かしたいモデル」→「必要なメモリ配置」→「使いたいランタイムや周辺ツール」→「製品」**の順序で考えると、容量だけを見て買った後にソフトウェア対応で困る失敗も減らせます。
参照元の公式情報・検証データ・一次ソース
- Qwen3.8 公式リポジトリ(Alibaba Cloud)
- SGLang公式ドキュメント:Prefill / Decode Disaggregation
- vLLM公式ドキュメント:GPU / Platform Installation
- Qwen3.8-Flash-Next VRAMベンチマーク・スケーリング検証(lukaLLM)
- Flash-Next 2x RTX 3090 実行検証・PLE構造解析(ruashots)
- Flash-Next PLE mmap実行検証・メモリ構造解析(0xBakeer)
- Flash-Next 4x RTX 3090 長文脈・Vision実行検証(alesha-pro)
- Flash-Next 4x V100-SXM2 高速実行検証(dg1kjd)
- SGLang Volta port(haohervchb)
- Single DGX Spark Flash-Next 4bit実行検証(albond)
- NVIDIA Developer Forums: Fitting Qwen3.8-Flash-Next onto one DGX Spark
- AMD Strix Halo Flash-Next実測(kksoftwareag)
- Apple M4 Max Flash-Next oMLX実測
- Apple、M5 Max / M5 Ultra Mac Studioを発表
- Apple Mac Studio仕様
- GLM-5.3-Flash M3 Ultra 256GB MLX 4bit(Rapid-MLX)
- GLM-5.3-Flash M3 Ultra 512GB oMLX
- 4x CMP 170HX GLM-5.3-Flash(PixelML / Club-170HX)
- 4x A100-SXM4 80GB GLM-5.3-Flash
- 4x RTX PRO 6000 Blackwell W4A16(voska)
- 2x DGX Spark GLM-5.3-Flash(rodman80)
- GLM-5.3-Flash 2x DGX Spark DFlash2(tonyd2wild)
- Qwen3.8-27B MTP benchmark corpus(sudoingX/qwen38-mtp)
- Intel Arc Pro B70 Qwen3.8-27B検証(0xSero/qwen38-b70)
- Radeon AI PRO R9700検証(boxwrench/R9700)
- LLM-Speed Qwen3.8-27B benchmark集約
- RTX 5090 / 4090 / 3090 Qwen3.8-27B比較(reichemistry)