LLMとは?「次のトークン予測」でなぜ会話・コード・推論までできるのか
モデルファイルの正体から、次トークン予測で広い能力が生まれるまで
最終更新 2026.09.20
目次6項目開く
ChatGPTに質問すると、数秒後には普通の文章で答えが返ってきます。
裏でGoogle検索して、どこかに保存されている「正解文」を持ってきているようにも見えますが、検索機能を使っていないときはそうではありません。
LLMは Large Language Model、大規模言語モデル の略です。文章を扱うとき、モデルはまず入力をトークンという細かな単位へ分けます。
トークンは文字でも単語でもありません。モデルが文章を処理するために使う区切りです。日本語だと、 AIのモデルや使われる文字(ひらがな、漢字、記号など)によって分割方法が変わり、1文字で1〜3トークンほどになることもあります。 英語の場合は「1トークン=約4文字」が一般的です。そのため、日本語の方が英語よりも1文字あたりのトークン数が多くなる傾向があります。
LLMは、そのトークン列を巨大なニューラルネットワークで計算して、次に来そうなトークンを1つ予測します。 AIの長い回答も、この繰り返しで伸びていきます。ここだけ聞くと、かなり巨大な予測変換に見えるかもしれません。
個人的には、LLMで一番面白いのはここだと思います。「続きを当てるだけの学習から、なぜ翻訳、コーディング、数学、推論まで出てきたのか。」という事です。
モデルファイルを開いても、Wikipediaは入っていない
LLMのイメージを掴むために、まずオープンウェイトという世界に公開されているモデルを実際に見てみると、理解しやすいと思います。Hugging Faceなどから数GB、モデルによっては数百GB以上のファイルをダウンロードできます。
以下はLlama3.1-405BというLLMです。BはBillionの略なので、およそ4000億個規模のパラメータを持ちます。
meta-llama/Llama-3.1-405B at main
We’re on a journey to advance and democratize artificial intelligence through open source and open science.
huggingface.co

1個約4GBのファイルが191個あるのが確認できます。しかし、その中に、
- 日本の首都.txt
- Pythonの書き方.md
- 歴史年表.json
みたいな資料が入っているわけではありません。大部分は、学習によって決まった大量の数値です。
tensor([
    [ 0.001953, -0.002930,  0.012695,  ..., -0.007812,  0.000977, -0.003906],
    [-0.004883,  0.001465, -0.009766,  ...,  0.015625, -0.001953,  0.002930],
    [ 0.000732, -0.000488,  0.003906,  ..., -0.001465,  0.005859, -0.001953]
], dtype=torch.bfloat16)
0.001953のような、単体で見ても意味の分からない数値1つ1つがパラメータです。Llama 3.1 405Bでは、こうしたパラメータが約4000億個あるということになります。
ここで出てくるのがパラメータと**重み(weights)**です。
パラメータは、学習によって値が調整されるモデル内部の数値です。LLMではその大部分が重みで、かなり単純化すると、ある情報を次の計算へどれくらい強く効かせるかを決める係数です。
LLMの知識や能力は、大量のパラメータの関係としてモデル全体へ分散していると考えた方が近いです。
なので、LLMは「巨大な検索エンジン」ではなく、学習で出来上がった重みを使って、その場で次の出力を計算するという仕組みです。
学習データの一部を強く記憶し、ほぼそのまま再現することはあります。ただ、普段の回答生成が「元記事を探して、その文章を取り出す」処理になっているわけではありません。
では、その数十億、数千億というパラメータをどうやって作るのか。
そこで出てくるのが、次のトークン予測です。
「続きを当てる」を何兆回もやる
学習前のモデルでは、重みはまだ日本語やコードの規則性を表す値になっていません。その状態で文章を入れても、まともな返答は期待できません。
そこで、大量の文章を使って次のトークンを当てる練習をします。
例えば、
東京は日本の首都です という文章があれば、モデルは文章の途中までを見て、その次を予測できます。
東京 → は
東京は → 日本
東京は日本 → の
東京は日本の → 首都
東京は日本の首都 → です
実際にはトークンの切れ方はTokenizerによって違うので、これは仕組みを分かりやすくした例です。
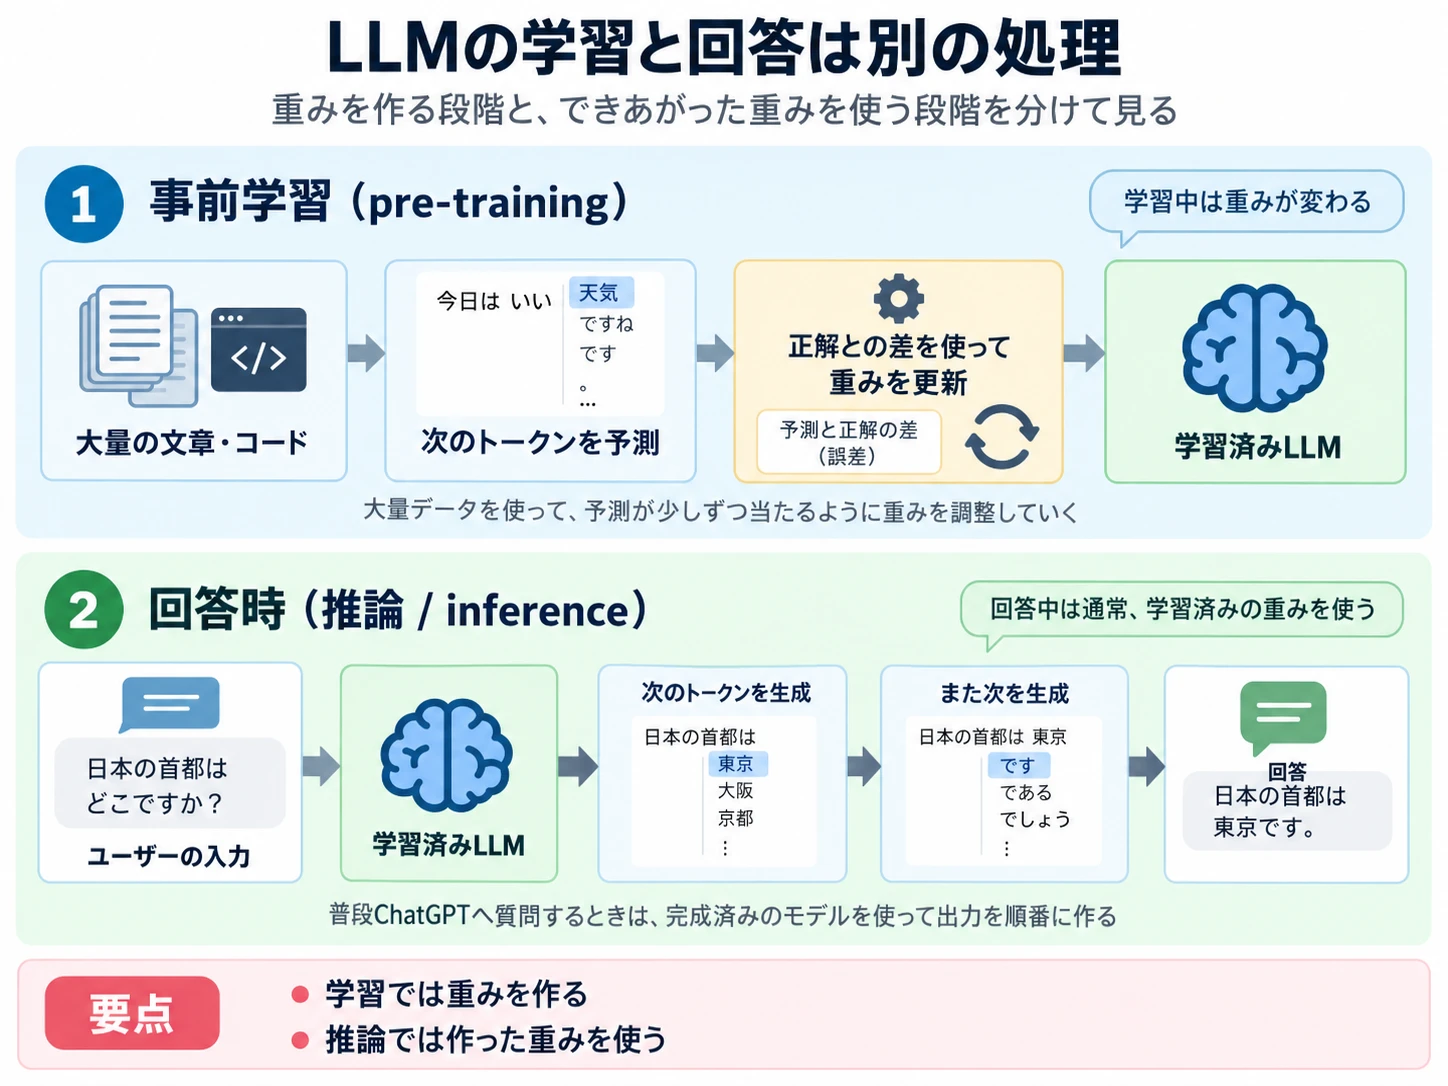
学習の最初は当然かなり外します。モデルは次に来そうな候補それぞれへ確率を出しているので、その予測と実際に続いていたトークンとの差を計算します。そして、次はほんの少しだけ正解へ近づくようにパラメータを更新する。
これを大量の文章やコードで繰り返します。
面白いのは、人間が一問ずつ「この問題の正解はこれ」とラベルを付けなくてもいいことです。元の文章に、次に何が続いたかという正解が最初から入っています。
大量の文章が、そのまま大量の練習問題になります。
MetaはLlama 3.1 405Bを15兆トークン超で事前学習したと公開しています。
Introducing Llama 3.1: Our most capable models to date
Bringing open intelligence to all, our latest models expand context length, add support across eight languages, and include Meta Llama 3.1 405B— the...
Meta AI

15兆です。
「続きを当てる練習」と言うとかなり単純ですが、その単純な練習をこの規模でやると話が変わってきます。
なぜコードまで書けるのか
「東京は日本の」の続きを当てるだけなら、よくある単語の並びを覚えるだけでかなりできそうです。
でも、学習データはそんな短文だけではありません。
プログラムの続きを正しく当てるなら、何十行も前で作った変数や関数の関係を追う必要があります。論文なら前提と結論、翻訳なら文全体の対応、物語なら登場人物と出来事の関係を外すと、次のトークンも外れます。
ここで話が面白くなります。
幅広い文章の続きを高い精度で当て続けるには、言葉の表面だけでは足りません。
例えば「はし」という言葉でも、「川にかかるはし」なら橋、「ご飯を食べるはし」なら箸です。「クラス」も、学校のクラスなのか、プログラム上のclassなのかで意味が変わります。毎回同じ意味として扱うより、周囲の文脈から「今これは何を表しているか」を捉えた方が、続きを正しく当てやすくなります。
学習を繰り返すうちに、モデル内部にはこうした予測に役立つ数値表現が作られていきます。文法、概念、コード構造、よく現れる関係、文章の型。しかも、それらは1つの問題だけでなく別の場面でも使えます。
「関数の引数と戻り値の関係」は別のコードでも役立つ。「原因と結果」のような関係は、ニュースでも論文でも会話でも出てきます。
こうした内部表現を大量の異なる文脈で使い回せるようになると、翻訳、要約、質問回答、コーディングのように別々に見える仕事も同じモデルで扱えるようになります。
ただし、ここから「人間と同じ意味理解が生まれた」とまでは言えません。モデル内部でどんな概念やアルゴリズムが形成され、なぜある能力は規模とともに伸び、別の能力は不安定なのかは今も研究されています。
それでも、単純に見える予測課題を巨大なデータとモデルで解かせると、予測のために必要な内部表現まで高度な知性のようになっていく。 ここがLLMを理解するうえで一番大事なところだと思います。
ただ、厳密にいうと中身がどうなっているのか、なんで高度な会話ができるのかはまだ研究対象なので、解釈の余地は色々あります。
Transformerが、長い関係を計算できるようにした
現在のLLMの土台になっているのがTransformerです。2017年の論文『Attention Is All You Need』で提案されました。
Transformerで有名なのがAttentionです。かなり単純に言えば、あるトークンを処理するときに、前後のどの情報をどれくらい参照するかを計算する仕組みです。
例えば、
太郎はコンビニで水を買った。家に戻ったあと、彼は冷蔵庫へ入れた。 「彼」が誰かを考えるには、少し前の「太郎」と結び付ける必要があります。 実際のTransformerはAttentionだけで動いているわけではありません。各トークンを数値ベクトルへ変換し、Attentionやfeed-forward networkなどを何層も重ねて表現を更新します。
細部まで入るとかなり専門的になるので、ここでは離れた情報同士の関係を扱いながら、大規模に学習しやすい構造だったくらいで十分だと思います。これが大量データと巨大なモデルとうまく噛み合いました。
でも、事前学習しただけではChatGPTにならない
ここまでの大規模な学習を**事前学習(pre-training)**と呼びます。
事前学習を終えたモデルは、文章やコードについてかなり広い能力を持っています。ただ、そのままでは「質問したら、その質問に答えてくれるAI」にはなっていません。事前学習でやっていたのは、基本的に文章の続きを予測することだからです。
例えば、
富士山の高さを教えて
と入力したとき、人間なら「3,776mです」と答えてほしいのだと分かります。でも、文章の続きを作るだけなら、
富士山の高さを教えてください。あと登山時期も知りたいです。 と、質問文そのものを続けても文章としては成立します。
そこで現在のチャットLLMでは、事前学習のあとに**事後学習(ポストトレーニング)**を行います。
「質問されたら答える」「指示された形式に従う」「難しい問題を解く」「ツールを適切に使う」といった、人間がAIに期待する振る舞いを追加で学習させます。
手法はモデルによって違いますが、教師あり学習、選好データを使った学習、強化学習などが使われます。
ここを「口調をChatGPTっぽく整える工程」くらいに考えると少し違います。事後学習によって、指示追従だけでなく、コーディング、ツール利用、推論性能なども大きく変わることがあります。
ChatGPTはLLMそのものではない
ここまで説明してきたLLMは、あくまでモデル本体です。
ChatGPTは、そのLLMにUI、検索、ファイル読み込み、コード実行などを組み合わせた製品です。
普通にChatGPTへ質問しているときも、その会話のたびにモデル全体を学習し直しているわけではありません。基本的には、すでに学習された重みを使って、現在の入力から回答を生成しています。
この、学習済みのモデルを使って実際に出力を作る処理を「推論(Inference)」と呼びます。
学習では重みを作る。 推論では、その重みを使う。
この2つは別の処理です。
そして、同じLLMを使っていても、その外側に何を組み合わせるかで製品としてできることはかなり変わります。
例えば検索機能を追加すれば、LLMが学習していない最新情報をWebから取得して回答に使えます。コード実行環境をつなげれば、計算やプログラムの実行結果を確認しながら答えることもできます。
だから、ChatGPTに新しい検索機能が追加されたからといって、LLMの重みそのものまで変わったとは限りません。
会話をどう保持するか、検索やメモリをどう使うか、AIエージェントがどう動くかは、それぞれ別の記事で詳しく扱います。
LLMそのものへ戻ると、核にある仕組みはかなり単純です。
大量のデータで次のトークンを予測しながら重みを作る。** **完成した重みと現在の文脈を使って、次のトークンを順番に生成する。
仕組みを書けばこれだけです。
かなりシンプルな概念ですが、そこから会話、翻訳、コード、推論までこれだけ幅広い能力を獲得したという事になります。